之前对容器化技术之Linux Namespace的相关知识进行了学习和梳理,了解了Linux内核如何支持虚拟化的相关技术特性;本文开始对Docker的存储结构进行相关梳理;
我们大家可能都知道Docker Image的结构是分Layer的,每层Layer的内容是相对于上一层Layer的差量内容,对于文件的新增或者修改都会创建一个新的Layer,Layers的存储方式是按照Stack的方式从下往上堆叠的;如下是一个比较直观的Image Layers构建堆叠的过程示意图(引用来源):
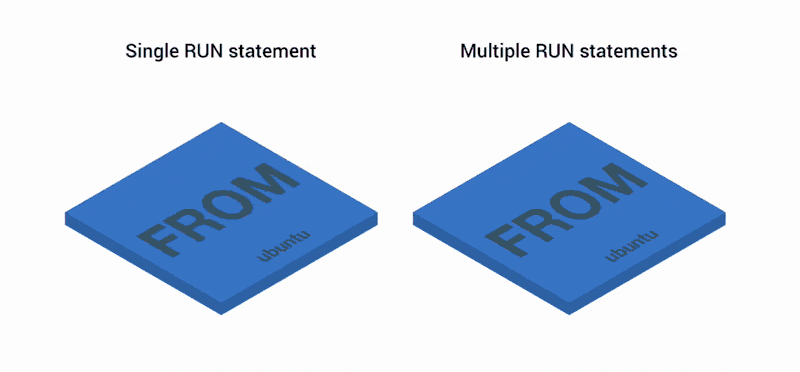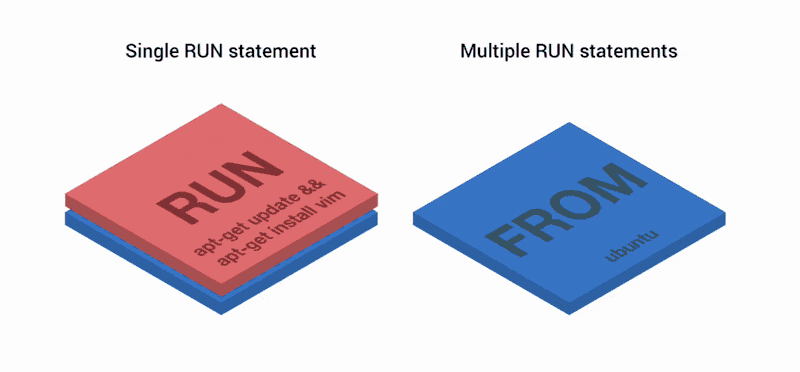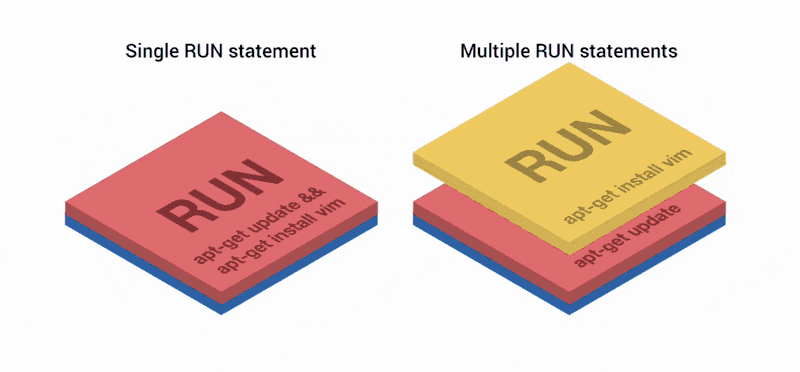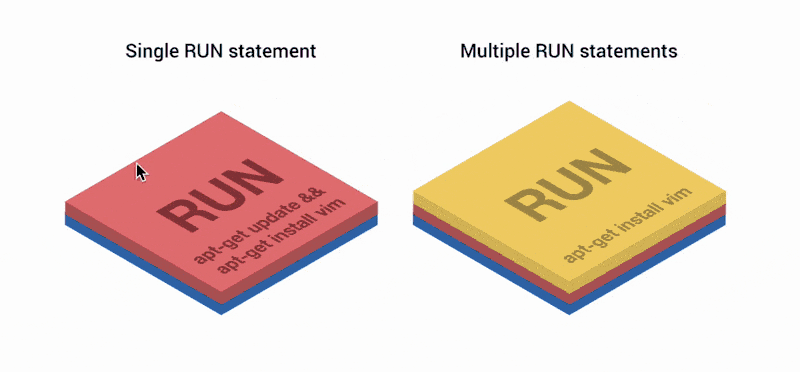
那么Docker是如何存储和管理Image的呢,这里我们就深入了解一下Docker关于Image的存储设计,知道这些设计,可以帮助我们更好的设计Image和持久化数据,以便提高程序的性能;
Docker通过存储驱动来存储Image的Read-Only Layers,在Container中是直接在Writable Layer中存储数据;Container的Writable Layer的数据是非持久化的,在Container销毁后就会丢失,适合保存运行时的临时数据;
**你可能会想为什么Container Writable Layer为什么不设计成Read-Only的,有需要写入的应用,使用Docker Volumes方式写入数据不可以吗?**其实这不现实的,很多负载以及基础镜像都会默认修改一些Image Read-Only Layers中的数据的,都使用Docker Volumes对应用是很不友好的,所以为了能够让Container直接在最上层的Writable Layer中写入数据,才引入的Docker存储驱动;
存储驱动在空间效率的设计上进行了优化,但是写入性能会比原生文件系统要差,特别是针对使用COW的存储驱动设计;针对写敏感的应用,会受到性能开销的影响,尤其是在修改已存在Read-Only Layer中的数据情况下;针对写敏感的数据,适合使用Docker Volumes,Docker Volumes同样适合Container持久化的数据,以及Container之间共享的数据;
那到底Image的各个Layer是怎么存储的?Container最终是如何使用各个Layer的内容的呢?Container是如何修改Image Layer中的Read-Only数据呢?下面就进入Docker 存储驱动的底层技术,首先进入Union mount的概念:
Union Mount File Systems
计算机中,Union Mounting是一种将多个不同的目录组合成一个统一的目录视图的技术;Union Mounting技术在Linux,FreeBSD,Plan9中都有相似的设计;Union Mount技术并不直接参与磁盘空间结构的划分和inode的管理,它依赖并建立在现有操作系统的文件系统之上(ext4,exFAT等),
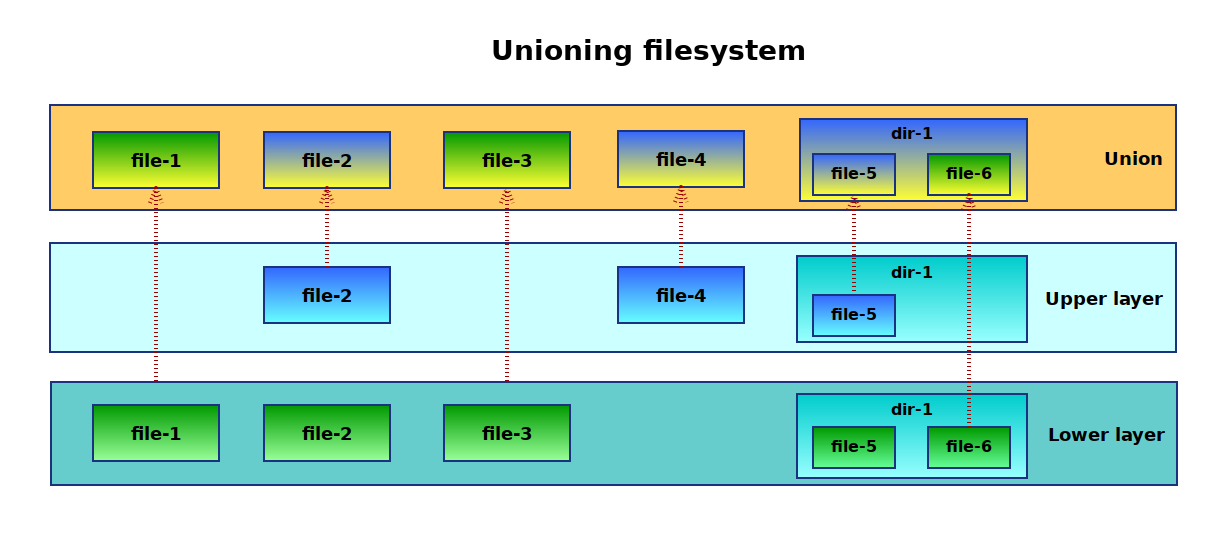
一个比较常见的应用场景就是:需要更新一些在CD-ROM 或者 DVD上的数据;例如DVD的播放进度;然后CD-ROM是Read-Only的文件系统;那怎么解决了?Union Mounting技术的解决方式是:在CD的挂载点上堆叠一个Writable的目录,这样对CD的修改,可以通过COW的方式写在Writable目录中,最终对外的表现就是感觉CD-ROM的内容是可以被修改的;
如下是Union Mount文件系统功能的示意图(参考):
在Linux版本中,Union Mount技术主要有以下几种实现:UnionFS,aufs,OverlayFS;
UnionFS
Union FS称之为一种可堆叠的联合文件系统,是为Linux, FreeBSD和NetBSD实现的一种为了将多个文件系统的目录的内容进行统一合并管理,且各个目录的内容仍然存在其各自的物理路径上;
UnionFS是由SBU的Erez Zadok教授和其团队研发的;发表于2004年「Kernel korner: unionfs: bringing filesystems together”」,目前UnionFS官方主站为:Unionfs: A Stackable Unification File System(应该已经没人维护了);
UnionFS它用来将各个独立的文件系统(称之为Branches)的不同目录和文件合并成一个单一的文件系统,针对合并过程中不同Branches之间出现相同的文件和目录,优先级更高的会覆盖优先级低的;不同Branches合并完成后,然后统一挂载,最后向用户呈现,所以称之为联合挂载技术;
针对各个不同的Branches,可能是read-only的,或者read-write的文件系统,针对最终合并统一挂载的文件系统的写入最终都会落到真实的文件系统中;这允许最终的统一挂载的文件系统是writable的,但对应Branch其实是read-only的,最终通过Copy-On-Write在统一挂载的文件系统中来进行write操作;当介质为物理只读时,例如Live CD,可能需要这样做。可以用来将多个CD-ROM的内容合并,多个软件包的目录进行合并
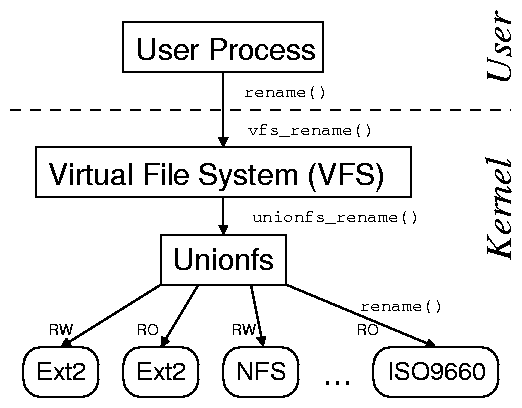
一言以蔽之,UnionFS的目的:将多个目录合并成一个单一的联合的视图;
如下是UnionFS的使用示意图(参考来源):
UnionFS有两个版本,「1.x」版本设计上是一个独立的可构建的模块,最新的版本是「2.x」的版本,相对于「1.x」进行了重新设计和实现;
aufs
aufs(advanced multi-layered unification filesystem)是由Junjiro Okajima in 2006开发的;aufs是完全基于UnionFS「1.x」版本重写的实现,旨在是为了可靠性和性能(可能「1.x」的工程实现太烂😂),同时引入了 一 些新的特性,例如Writable分支的负载均衡 。 aufs的一些实现已经被纳入UnionFS「2.x」 版本;具体支持aufs文件管理的Linux发行版本可以参考Wikipedia;
aufs由于代码设计上可读性太差,没有注释,结构太密等糟糕的设计,被拒绝合入Linux Kernel;最终经过多次修改和尝试后,作者放弃了合入Linux Kernel Mainline;
OverlayFS
OverlayFS是另一款为了Linux开发的Union Mount文件系统的实现;它同样是将很多底层不同挂载点目录组合成一个单一的目录结构,包含所有底层挂载点目录和内容;它是通过将一个个目录进行堆叠来最终合并成一个单一的目录;
2009年,关于Linux Kernel需要一个Union Mount filesystem的话题被提出:Unioning file systems: Architecture, features, and design choices;
2010年,Miklos Szeredi提交了OverlayFS的初始RFC;
2011年,OpenWrt采用OverlayFS的实现;
2014年10月26日,OverlayFS被合入了Linux kernel主线 「3.18」;
2015年4月12日,Linux「4.0」更新了OverlayFS,为了支持Docker的overlay2的存储驱动;
参考OverlayFS的内核文档,OverlayFS逐个将不同的文件系统进行堆叠,在组合的两个文件系统,分别称之为:upper文件系统和lower文件系统,
- 针对同名的文件对象同时存在不同的文件系统中,upper文件系统的同名文件具有更高的优先级,会覆盖lower文件系统的文件;
- 针对同名的目录,会从upper文件系统向lower进行合并;
- upper文件系统通常是可写的;当然也可以是只读的,那么最终合并的文件系统也是只读的;
- lower文件系统可以是Linux支持的任意文件系统,不要求是可写的,lower文件甚至可以同样是一个OverlayFS;
更准确的说法可能是:upper目录树和lower目录树,而不是文件系统,因为通常的情况是两个目录树都是同一个文件系统;这和一些其他的需要合并不同文件系统的Union Mount实现相比,OverlayFS并不需要来自不同的文件系统,即可以是相同的文件系统;OverlayFS还支持的一些特性有:
-
支持upper文件系统对lower文件系统进行文件和删除操作;这种操作是通过针对目录进行whiteouts和opaque处理
-
不支持从lower文件系统向upper文件系统合并变更;
OverlayFS可以通过mount命令来进行测试,如下:
bashmount -t overlay overlay -olowerdir=/lower,upperdir=/upper,workdir=/work /merged
- lowerdir=directory:需要挂载的任意Linux支持的文件系统目录,支持多目录,用
:分隔;lowerdir的文件系统可以是Read-Only,也可以是Writable; - upperdir=directory:需要挂载的upperdir目录,只支持单个目录,可以没有;upperdir通常是Writable的,当然可以是Read-Only;
- workdir=directory:和upperdir目录必须相同的文件系统,必须是一个空目录;挂载后内容会被清空,且在使用过程中其内容用户不可见;
最后一个参数是挂载点,upper和lower目录堆叠之后,会统一显示在挂载点中,挂载点中的所有文件都只是lowerdir和upperdir的文件映射;该映射保存在挂载后的Overlay文件系统的dentry目录结构中,整个OverlayFS的结构定义如下:
c// https://github.com/torvalds/linux/blob/master/fs/overlayfs/ovl_entry.h
struct ovl_fs {
// layer层数
unsigned int numlayer;
/* Number of unique fs among layers including upper fs */
unsigned int numfs;
const struct ovl_layer *layers;
struct ovl_sb *fs;
/* workbasedir is the path at workdir= mount option */
struct dentry *workbasedir;
/* workdir is the 'work' directory under workbasedir */
struct dentry *workdir;
/* index directory listing overlay inodes by origin file handle */
struct dentry *indexdir;
long namelen;
/* pathnames of lower and upper dirs, for show_options */
struct ovl_config config;
/* creds of process who forced instantiation of super block */
const struct cred *creator_cred;
bool tmpfile;
bool noxattr;
/* Did we take the inuse lock? */
bool upperdir_locked;
bool workdir_locked;
bool share_whiteout;
/* Traps in ovl inode cache */
struct inode *workbasedir_trap;
struct inode *workdir_trap;
struct inode *indexdir_trap;
/* -1: disabled, 0: same fs, 1..32: number of unused ino bits */
int xino_mode;
/* For allocation of non-persistent inode numbers */
atomic_long_t last_ino;
/* Whiteout dentry cache */
struct dentry *whiteout;
/* r/o snapshot of upperdir sb's only taken on volatile mounts */
errseq_t errseq;
};
下面做一个OverlayFS的简单测试,如下:创建一个目录结构:
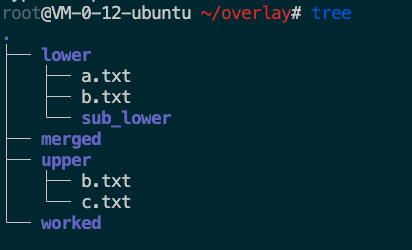
通过如下命令进行OverLayFS挂载到merged目录:挂载后的结果如下:
bashmount -t overlay overlay -olowerdir=lower,upperdir=upper,workdir=worked merged
挂载后,我们线看一下整个操作系统文件系统的变化:
bash# df -h
Filesystem Size Used Avail Use% Mounted on
udev 947M 0 947M 0% /dev
tmpfs 199M 804K 198M 1% /run
/dev/vda2 50G 15G 33G 32% /
tmpfs 994M 48K 994M 1% /dev/shm
tmpfs 5.0M 0 5.0M 0% /run/lock
...
overlay 50G 15G 33G 32% /root/overlay/merged # 新创建的overlay文件系统,
# 通过mount命令查看所有的文件系统挂载信息
# mount
...
overlay on /root/overlay/merged type overlay (rw,relatime,lowerdir=lower,upperdir=upper,workdir=worked,xino=off)
下面是OverlayFS挂载后,目录试图如下:
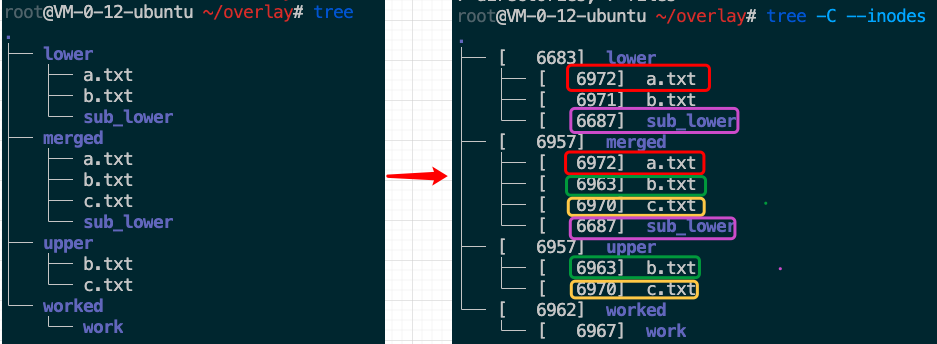
你会发现merged的目录内的对象的inode节点映射关系:
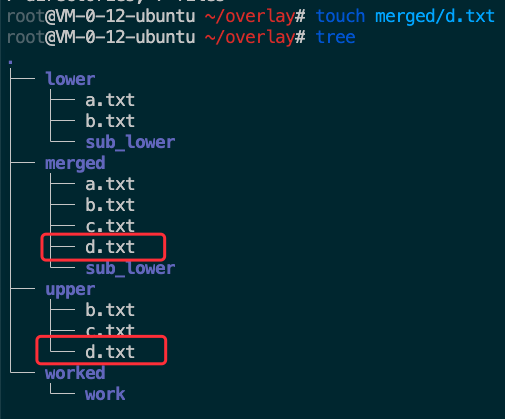
merged/a.txt->lower/a.txtmerged/b.txt->upper/b.txtmerged/c.txt->upper/c.txtmerged/sub_lower->lower/sub_lower
我们可以看到针对同名文件,upper目录中的会覆盖lower目录的,前面说了:堆叠后的所有文件都只是lowerdir和upperdir的文件映射,该映射保存在挂载点的dentry目录结构中;并不是通过什么hard link来实现的:如下:堆叠后文件的硬连接数还是1;
shell# stat merged/a.txt
File: merged/a.txt
Size: 8 Blocks: 8 IO Block: 4096 regular file
Device: 41h/65d Inode: 6972 Links: 1
Access: (0644/-rw-r--r--) Uid: ( 0/ root) Gid: ( 0/ root)
Access: 2022-12-08 20:30:58.687903816 +0800
Modify: 2022-12-08 20:30:57.811888477 +0800
Change: 2022-12-08 20:30:57.811888477 +0800
Birth: -
我们创建的upper目录是Writable的,所以我们可以在挂载目录中创建新的d.txt,如下,会发现会最终在upper目录中进行了修改;
Docker Storage
前面花了那么多篇幅介绍Union Mount filesystem,就是因为Docker的默认存储驱动就是采用了Union Mount的技术的OverlayFS;Docker最初采用aufs作为Container的存储驱动,虽然现在Docker仍然支持aufs,但是默认的存储驱动已经切换为OverlayFS的overlay2版本了;
Docker除了aufs,OvleryFS,还支持Btrfs,ZFS,VFS等FileSystem;Docker官网上列出了各种支持的Union Mount列表和对应的Linux发行版的支持情况,由于OverlayFS已经在Linux kernel「3.18」就纳入了内核,所以基本所有Linux 发行版都支持,这也是Docker默认采用OverlayFS作为存储驱动的原因;下面就从Docker Image Layer和Container Layer出发,来看一下Docker是如何做存储管理的;
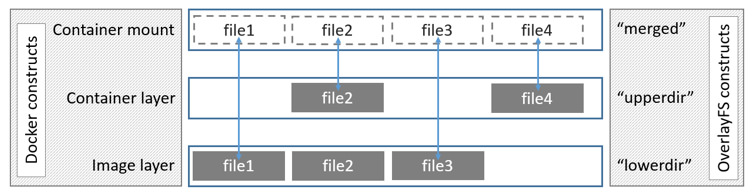
下图是Docker关于OverlayFS如何作为存储驱动的示意图:
Docker Image的存储结构
先从一个Image的构建示例入手,如下:
dockerfileFROM public.ecr.aws/lts/ubuntu
COPY helloworld .
CMD ["./helloworld"]
构建过程的标准输出如下:
shell$ docker build -t helloworld .
Sending build context to Docker daemon 2.136MB
Step 1/3 : FROM public.ecr.aws/lts/ubuntu
latest: Pulling from lts/ubuntu
e5a90e366ec6: Pull complete
Digest: sha256:af80a21bd3fec732e1172832915022e1f42ab6eeddc6b8a553be1065a62955be
Status: Downloaded newer image for public.ecr.aws/lts/ubuntu:latest
---> 722f31009f7d
Step 2/3 : COPY helloworld .
---> c284d9a8857f
Step 3/3 : CMD ["./helloworld"]
---> Running in 4a7b0d9ef0d4
Removing intermediate container 4a7b0d9ef0d4
---> b74d0485e01e
Successfully built b74d0485e01e
Successfully tagged helloworld:latest
上述构建过程成,每一个Step都创建了一个Image,构建完后,查看镜像列表如下:
shell$ docker images -a
REPOSITORY TAG IMAGE ID CREATED SIZE
helloworld latest b74d0485e01e 11 days ago 79.9MB
<none> <none> c284d9a8857f 11 days ago 79.9MB
public.ecr.aws/lts/ubuntu latest 722f31009f7d 3 weeks ago 77.8MB
那么,ImageID是如何生成的,以及是如何和Image的Storage Layer进行关联的呢?
Image的元数据管理信息
首先,我们看一下Image的管理结构信息;Docker对于Image的管理信息都维护在/var/lib/docker/image/overlay2中,如下:
bash$ tree /var/lib/docker/image/overlay2/ -L 1
/var/lib/docker/image/overlay2/
├── distribution/ # Image的所有Layer diffid和digest映射关系
├── imagedb/ # 本地所有Image的元数据信息
├── layerdb/ # 本地所有Image的所有Layer的索引结构
└── repositories.json # 本地所有repo的所有版本Image的信息
Image的元数据信息是什么呢?我们看一下imagedb的中元数据的内容:
bash$ tree /var/lib/docker/image/overlay2/imagedb/
├── content
│ └── sha256
│ ├── 722f31009f7dcdbdb4cdf566baad517e9874ad668818c71c1133f7e8fc45520c
│ ├── b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817
│ └── c284d9a8857fdabb5e15b8962933ebc639235e6901fcb573e6073fd08ca89403
└── metadata
└── sha256
├── b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817
│ ├── lastUpdated
│ └── parent
└── c284d9a8857fdabb5e15b8962933ebc639235e6901fcb573e6073fd08ca89403
└── parent
我们可以看到/var/lib/docker/image/overlay2/imagedb/content/sha256列出了本地所有的Image,每个Image ID对应的文件内容就是该Image的配置信息:我们看一下helloworld镜像的配置文件内容:
json$ cat /var/lib/docker/image/overlay2/imagedb/content/sha256/b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817
{
"architecture": "amd64",
"config": {
"Hostname": "",
"Domainname": "",
"User": "",
"AttachStdin": false,
"AttachStdout": false,
"AttachStderr": false,
"Tty": false,
"OpenStdin": false,
"StdinOnce": false,
"Env": [
"PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"
],
"Cmd": [
"./helloworld"
],
"Image": "sha256:c284d9a8857fdabb5e15b8962933ebc639235e6901fcb573e6073fd08ca89403",
"Volumes": null,
"WorkingDir": "",
"Entrypoint": null,
"OnBuild": null,
"Labels": {
"org.opencontainers.image.ref.name": "ubuntu",
"org.opencontainers.image.version": "22.04"
}
},
...
"os": "linux",
"rootfs": {
"type": "layers",
"diff_ids": [
"sha256:f4a670ac65b68f8757aea863ac0de19e627c0ea57165abad8094eae512ca7dad",
"sha256:174ab39f291248670e2f132a14641fd387f23bcd6970e706635dd2a9e42488ae"
]
}
}
那么,回到ImageID是如何生成的问题,ImageID就是该Image的元数据的配置文件信息的sha256的结果,如下,Docker也是通过ImageID来命名该Image的配置文件的:
bash$ sha256sum /var/lib/docker/image/overlay2/imagedb/content/sha256/b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817
b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817 /var/lib/docker/image/overlay2/imagedb/content/sha256/b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817
imagedb中的/var/lib/docker/image/overlay2/imagedb/metadata/sha256维护了Image之间的继承关系;可以通过ImageID定位到Image所有的层级继承关系,docker history命令就是通过imagedb的metadata的parent映射来查看的,如下:
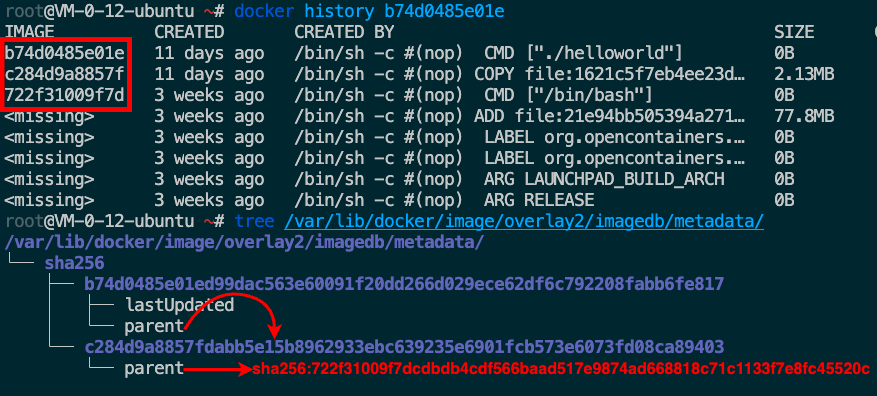
imagedb的metadata的image层级映射关系只存在本地构建中,这是数据对于最终构建的Image的运行没有作用,所以你会发现,从远端pull下来的Image是没有这些映射的,也就是为什么远端拉取的Image进行docker history时会出现很多<missing> Image的ID信息;例如我们把构建的helloworld Image push到registry,然后再在其他机器上pull下来,imagedb这些metadata的信息会全部为空,如下:
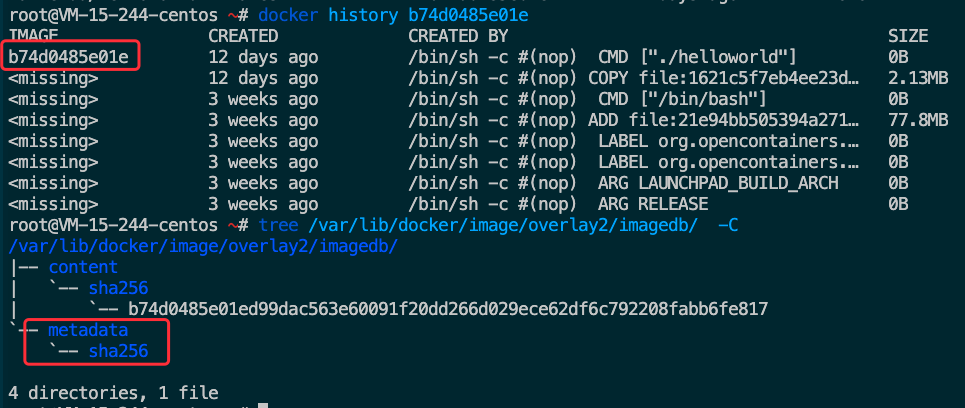
Image Layer的元数据管理信息
前面讲到了Image的元数据管理信息结构,分布在目录:/var/lib/docker/image/overlay2/imagedb中,Image的另一部分很重要的管理信息就是:层级管理信息,分布在目录:**/var/lib/docker/image/overlay2/layerdb**中;我们先看一下我们构建的helloworld镜像的层级信息;
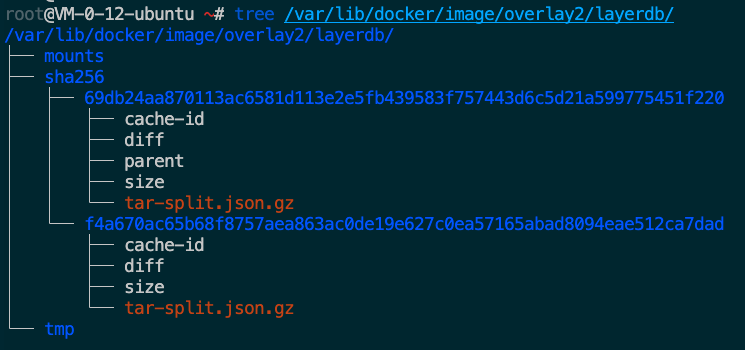
前面学习后,我们知道Docker Image&Container的存储驱动采用OverlayFS来进行Layer的存储和管理,Docker中将Layer的只读层定义为type roLayer struct,将读写层定义为type mountedLayer struct,我们先看一下只读层的定义,如下:
go//https://github.com/moby/moby/blob/master/layer/ro_layer.go
type roLayer struct {
chainID ChainID
diffID DiffID
parent *roLayer
cacheID string
size int64
layerStore *layerStore
descriptor distribution.Descriptor
referenceCount int
references map[Layer]struct{}
}
关于只读层有几个关键的标识:具体可参考Layer创建的源码registerWithDescriptor();下面按照各个ID的生成先后来说明:
- CacheID:随机数值串,在Image的一个roLayer创建的时候随机生成;它会作为索引存储对应Layer的数据,后面会介绍;注意:CacheID是宿主机创建或者拉取Imag的时候随机生成的,同一个Image被Push然后Pull后,该值是会变的;
- DiffID:在rolLayer创建的时候,根据该roLayer的打包文件计算出的签名值;注意:该值是在Image创建后就固定不变的,也是用来计算ChainID的前提;DiffID作为Image roLayer的签名,会被写入到Image的元配置信息中,如下:
bash// 也可以通过docker inspect查看
$ cat /var/lib/docker/image/overlay2/imagedb/content/sha256/b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817
...
"rootfs": {
"type": "layers",
"diff_ids": [
"sha256:f4a670ac65b68f8757aea863ac0de19e627c0ea57165abad8094eae512ca7dad",
"sha256:174ab39f291248670e2f132a14641fd387f23bcd6970e706635dd2a9e42488ae"
]
}
}
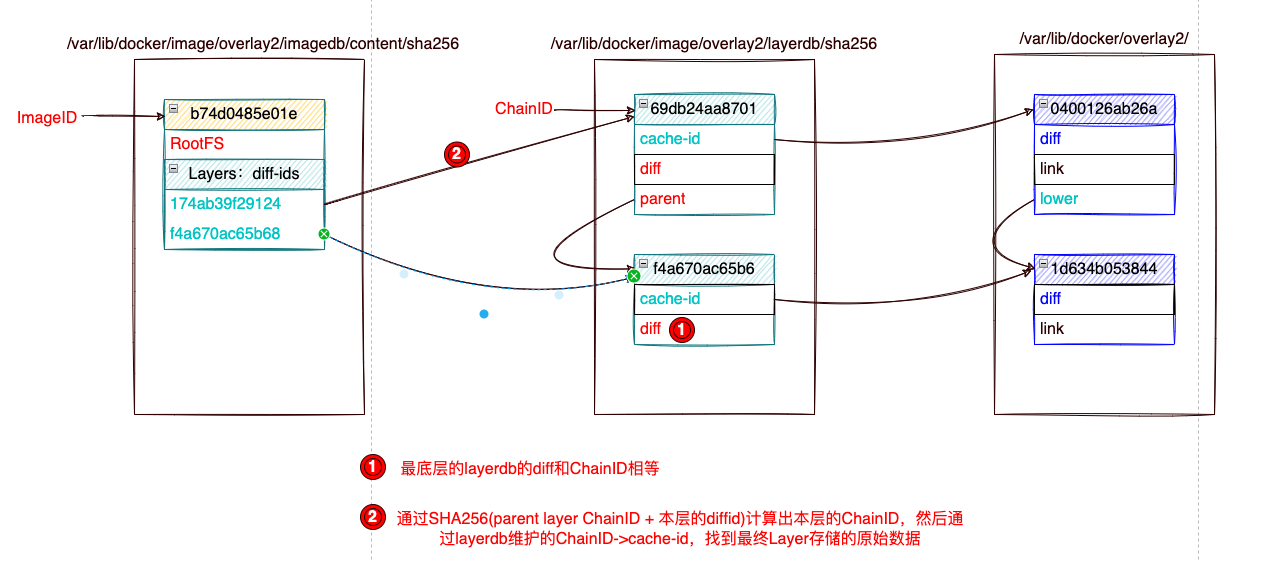
- ChainID:在CacheID和DiffID生成后,会根据parent layer来计算本层的ChainID,ChainID作为Layerdb层级信息的key来组织管理Image的Layerdb层级信息;如下是ChainID的计算过程:如果该Layer是最底层Layer,那么该层:
ChainID=DiffID,否则ChianID=SHA256(parent Layer ChainID + " " + DiffID)
go// https://github.com/moby/moby/blob/master/layer/layer_store.go
if layer.parent == nil {
layer.chainID = ChainID(layer.diffID)
} else {
layer.chainID = createChainIDFromParent(layer.parent.chainID, layer.diffID)
}
下面是通过DiffID计算ChainID的测试:可以得知helloworld顶层的ChainID=69db24aa8701是如何根据上一层的ChainID和本层的DiffID生成的:
bash$ echo -n "sha256:f4a670ac65b68f8757aea863ac0de19e627c0ea57165abad8094eae512ca7dad sha256:174ab39f291248670e2f132a14641fd387f23bcd6970e706635dd2a9e42488ae"|sha256sum
69db24aa870113ac6581d113e2e5fb439583f757443d6c5d21a599775451f220 -
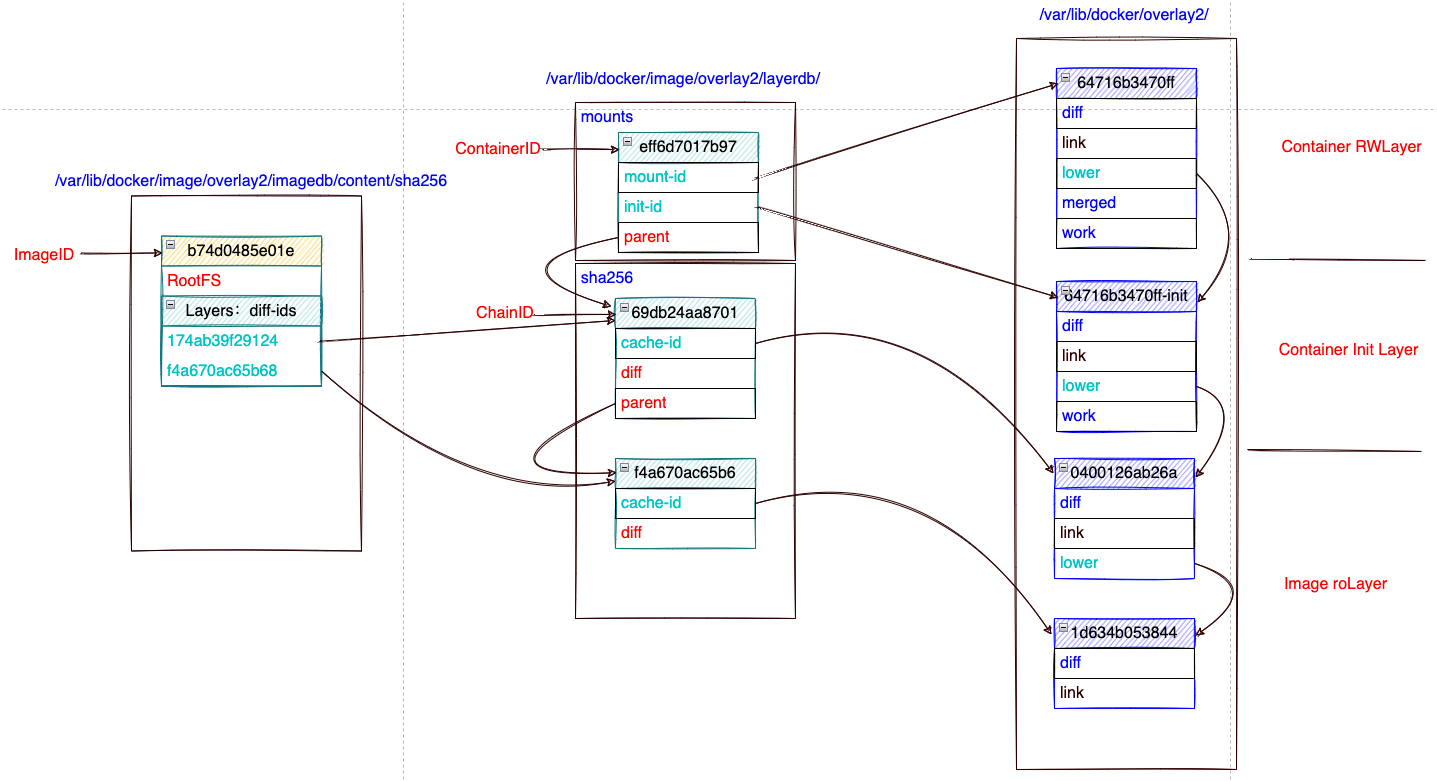
下图是描述了Docker是如何从ImageID,映射到Imagedb的元数据,再根据Imagedb元数据映射到Layerdb元数据,最终找到Image的各个Layer数据的关系(下一节细说Layer数据的结构);
Image的Layer内容
Image的所有Layer的内容都是存储在/var/lib/docker/overlay2中,如下是构建完helloworld Image后的Layer存储信息,如下:
bash$ tree /var/lib/docker/overlay2/ -L 2 -C
/var/lib/docker/overlay2/
├── 0400126ab26a2518158499aaf33b908ae609f9fd473fbd7a02bfcb1fb79f462a/
│ ├── committed
│ ├── diff/
│ ├── link
│ ├── lower
│ └── work/
├── 1d634b053844bb57fd92c8f974b4387f151e9037a681cbe98cf00cb9e3f5c034/
│ ├── committed
│ ├── diff/
│ └── link
└── l/
├── 7R3BV4DSUXAU3AKFTFHCZHDYW3 -> ../1d634b053844bb57fd92c8f974b4387f151e9037a681cbe98cf00cb9e3f5c034/diff
└── AGDRXIWIU2JNKYW6JDMJFS6GR3 -> ../0400126ab26a2518158499aaf33b908ae609f9fd473fbd7a02bfcb1fb79f462a/diff
我们可以看到overlay2目录中有两个Layer,目录名是该Layer创建的时候随机生成的CacheID;最开始介绍Docker存储驱动时,我们知道Docker默认采用OverLayFS,Layer之间时堆叠组合最终生成文件系统视图;上面两个Layer的堆叠关系在前面一节最后图中也有说明;0400126ab26a/lower->1d634b053844,Layer目录中目录结构含义:
- diff目录:该Layer相对于parent Layer(这里翻译层上一层和下一层都容易误解)差量的文件集合;
- lower:保存parent Layer的CacheID;
- link:保存CacheID对应的短名字,短名字是为了防止在mount的时候出现参数溢出的问题;
- l目录:保存所有Layer的CacheID对应的短名字,以symbol link的方式指向Layer对应的CacheID名字的目录;
我们可以看一下各个Layer里面真实的diff文件内容,如下:
bash# tree /var/lib/docker/overlay2/ -L 3 -C
/var/lib/docker/overlay2/
├── 0400126ab26a2518158499aaf33b908ae609f9fd473fbd7a02bfcb1fb79f462a
│ ├── committed
│ ├── diff
│ │ └── helloworld
│ ├── link
│ ├── lower
│ └── work
├── 1d634b053844bb57fd92c8f974b4387f151e9037a681cbe98cf00cb9e3f5c034
│ ├── committed
│ ├── diff
│ │ ├── bin -> usr/bin
│ │ ├── boot
│ │ ├── dev
│ │ ├── etc
│ │ ├── home
│ │ ├── lib -> usr/lib
│ │ ├── lib32 -> usr/lib32
│ │ ├── lib64 -> usr/lib64
│ │ ├── libx32 -> usr/libx32
│ │ ├── media
│ │ ├── mnt
│ │ ├── opt
│ │ ├── proc
│ │ ├── root
│ │ ├── run
│ │ ├── sbin -> usr/sbin
│ │ ├── srv
│ │ ├── sys
│ │ ├── tmp
│ │ ├── usr
│ │ └── var
│ └── link
可以看到:
0400126ab26a/diff:是helloworld镜像构建的测试程序,该层只有该新增的文件;1d634b053844/diff:是基础镜像ubuntu的整个文件系统;
Image的Digest
从Image元数据管理信息中,我们知道ImageID是通过Image的元数据配置信息文件经过SHA26得到的Hash值;那么我们知道每个Image都有一个不同于ImageID的Image Digest,这让我很困惑了,Image ID其实也是一种Digest,为什么还需要一个单独的Image Digest呢?
我们先看一下Image Digest的设计场景,我们可以通过docker run <repo>:<tag>来运行一个Container,由于Image的<repo>:<tag>是一个可变引用,也就是说其指向的Image可能以及被更新了,不是我们想要的镜像;Docker提供了@sha256:<digest>的方式来引用一个Image,通过Digest来引用一个镜像可以保证绝对的安全;
Image的Digest是Docker Registry V2引入的,它是Image的manifest的Hash值;Image的manifest是Push到Registry的Image必须创建的,它用于决定在下载一个Image的具体Layerdb;例如docker run一个Registry的Image,或者docker pull一个Register的Image的时候;Image的manifest不会存放在宿主机上,它只存在于Registry中,我们通过docker manifest inspec REPO_IMAGE是会向Registry请求manifest数据;
如下是我们构建的helloworld镜像的Digest信息:

本地构建的helloworld镜像是没有Digest的,所以Digest并不和ImageID一样,它不是在Image构建的的时候生成的,只有通过docker manifest create或者docker push的是时候才会创建,且创建在远端的Registry中的;
我们可以看一下Image对应的manifest信息是什么:
bash$ docker manifest inspect walkerdu/helloworld
{
"schemaVersion": 2,
"mediaType": "application/vnd.docker.distribution.manifest.v2+json",
"config": {
"mediaType": "application/vnd.docker.container.image.v1+json",
"size": 2528,
"digest": "sha256:b74d0485e01ed99dac563e60091f20dd266d029ece62df6c792208fabb6fe817"
},
"layers": [
{
"mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
"size": 30425607,
"digest": "sha256:e96e057aae67380a4ddb16c337c5c3669d97fdff69ec537f02aa2cc30d814281"
},
{
"mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
"size": 1112607,
"digest": "sha256:9a6eee59a40caa9250141be530e1fb59f3aadea40799601493615ff03ca36ef4"
}
]
}
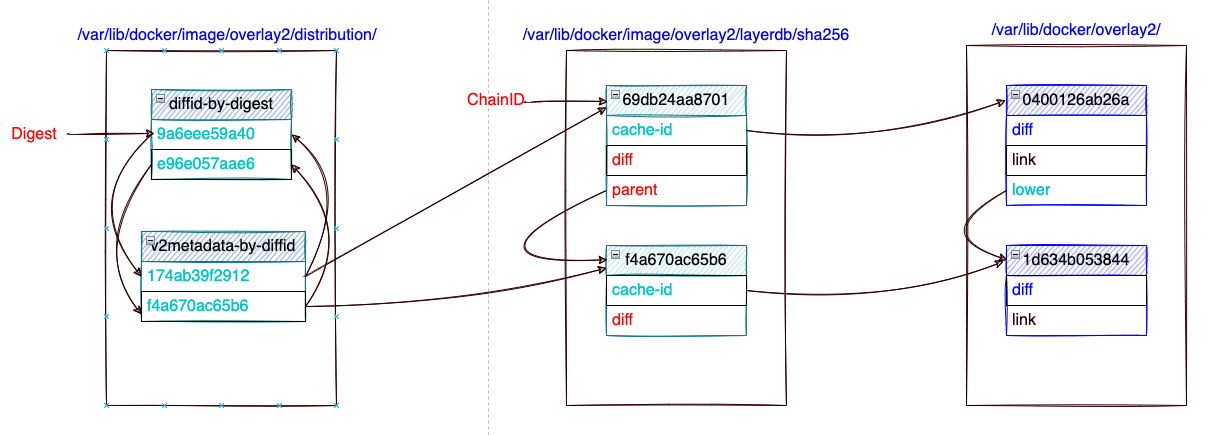
我们可以看到manifest里面有两个Layers,每个Layer分别对应该Layer的Digest,前面在介绍Image管理信息结构的时候有个distribution目录,我们在把构建的helloworld` Push到DockerHub的Registry后,可以看到:
bash$ tree /var/lib/docker/image/overlay2/distribution/
/var/lib/docker/image/overlay2/distribution/
|-- diffid-by-digest
| `-- sha256
| |-- 9a6eee59a40caa9250141be530e1fb59f3aadea40799601493615ff03ca36ef4
| `-- e96e057aae67380a4ddb16c337c5c3669d97fdff69ec537f02aa2cc30d814281
`-- v2metadata-by-diffid
`-- sha256
|-- 174ab39f291248670e2f132a14641fd387f23bcd6970e706635dd2a9e42488ae
`-- f4a670ac65b68f8757aea863ac0de19e627c0ea57165abad8094eae512ca7dad
这里面就是保存所有Image的Layer的DiffID和Digest的映射关系,方便通过Digest来定位具体Layer的数据,如下是Image的Digest到Layer元数据,Layer内容之前的一个映射示意图;
其实,这也没有解释我的困惑:Image ID其实也是一种Digest,为什么还需要一个单独的Image Digest呢?ImageID在防止Image引用变更的时候同样可以保证安全的,待后面探究吧;
Docker Container的存储结构
上面通过构建的helloworld镜像了解了Image的元数据信息和Layer具体的内容,那么Container基于Image之上是如何组织Container信息的,以及我们知道基于OverlayFS的存储结构,在Container运行时,是如何进行挂载的?
首先我们运行Image:
bash# docker run -d b74d0485e01e
eff6d7017b97a15b484b7d7d4e2b9b36dbe98cf806b0c0c4cfb3fe0c6f0e2e22
运行Image后,发现在layerdb中的mounts目录多了一个以ContainerID为目录的layer元数据管理层;
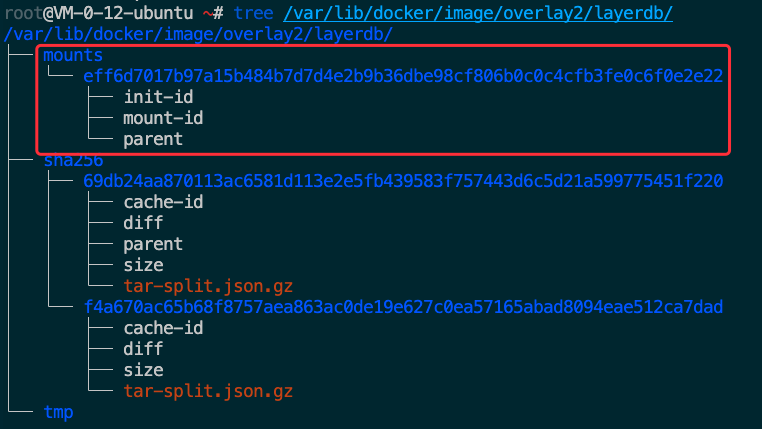
前面介绍Image Layer的时候我们知道Docker中将Layer的只读层定义为type roLayer struct,将读写层定义为type mountedLayer struct,我们这里看一下读写层的定义,如下:
go//https://github.com/moby/moby/blob/master/layer/mounted_layer.go
type mountedLayer struct {
name string
mountID string
initID string
parent *roLayer
layerStore *layerStore
sync.Mutex
references map[RWLayer]*referencedRWLayer
}
读写层是在Container运行的时候才会创建的,创建的目录和Image的Layerdb元数据平级的mounts目录,关于mounts的目录结构有以下几个关键的标识,参考mountedLayer创建的源码CreateRWLayer():
- mountID:在mountedLayer读写层创建的时候,随机生成的Hash串,和roLayer的CacheID是完全一样的,同样用来索引Container的读写层Layer内容;该读写层就是OverlayFS里说的统一挂载后,面向Container的统一操作的文件系统视图;
- initID:是由
mountID+"-init"拼接而成,同样会索引到Container的init Layer的内容;该init Layer本身也是mountedLayer,最终Container的读写层是基于该init Layer+Image roLayer堆叠而成的; - parent:指向Image最顶层的roLayer的ChainID;
Container创建后,除了上面layerdb多出了mounts 读写层相关的Layer元数据信息之外,overlay2的Layer存储目录中也多了下面两个目录:
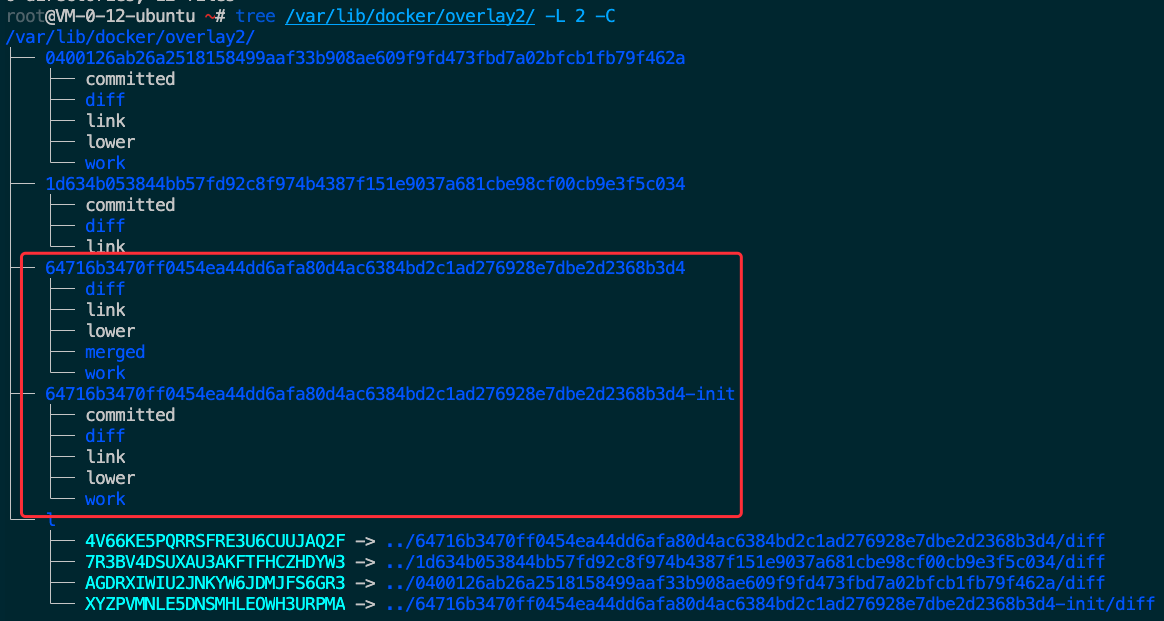
我们可以在回头看一下Layerdb里面mountID和initID信息,如下:他们用来索引最终Layer存储目录的对应信息:
bash$cd /var/lib/docker/image/overlay2/layerdb/mounts/
$cat eff6d7017b97a15b484b7d7d4e2b9b36dbe98cf806b0c0c4cfb3fe0c6f0e2e22/init-id
64716b3470ff0454ea44dd6afa80d4ac6384bd2c1ad276928e7dbe2d2368b3d4-init⏎ $cat eff6d7017b97a15b484b7d7d4e2b9b36dbe98cf806b0c0c4cfb3fe0c6f0e2e22/mount-id
64716b3470ff0454ea44dd6afa80d4ac6384bd2c1ad276928e7dbe2d2368b3d4
我们再看一下overlay2里面新增的两个Layer里面的堆叠信息:最终Container的读写层是基于Image roLayer + Container init-Layer堆叠而成;
bash$cd /var/lib/docker/overlay2/
$cat 64716b3470ff0454ea44dd6afa80d4ac6384bd2c1ad276928e7dbe2d2368b3d4-init/lower
l/AGDRXIWIU2JNKYW6JDMJFS6GR3:l/7R3BV4DSUXAU3AKFTFHCZHDYW3
$cat 64716b3470ff0454ea44dd6afa80d4ac6384bd2c1ad276928e7dbe2d2368b3d4/lower
l/XYZPVMNLE5DNSMHLEOWH3URPMA:l/AGDRXIWIU2JNKYW6JDMJFS6GR3:l/7R3BV4DSUXAU3AKFTFHCZHDYW3
我们可以看一下最终读写层的diff变更,就是我们helloworld镜像1号进程输出的结果文件:
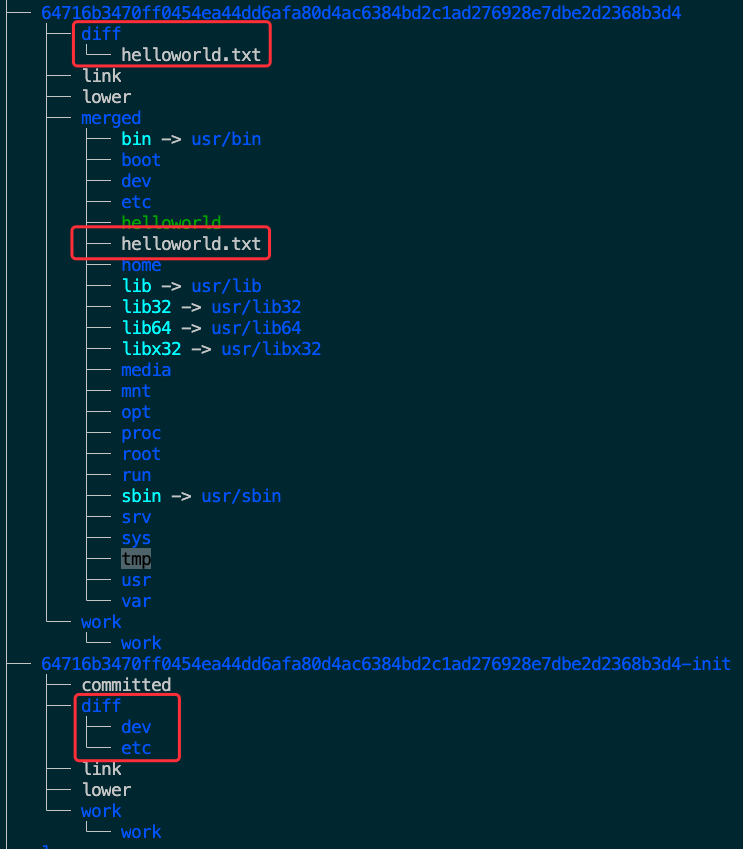
加上Container后,在前面如何从ImageID,映射到Imagedb的元数据,再根据Imagedb元数据映射到Layerdb元数据,最终找到Image的各个Layer数据的关系,我们再加上一层ContainerID到mountedLayer读写层的Layerdb,以及Container的Layer的映射关系如下图:
参考
https://stackoverflow.com/questions/31222377/what-are-docker-image-layers
https://www.cnblogs.com/wdliu/p/10483252.html
https://stackoverflow.com/questions/46649592/dockerd-vs-docker-containerd-vs-docker-runc-vs-docker-containerd-ctr-vs-docker-c
https://blogs.cisco.com/developer/container-image-layers-1
https://containerd.io/img/architecture.png
https://www.baeldung.com/linux/docker-image-storage-host
https://zhuanlan.zhihu.com/p/47381629 https://zhuanlan.zhihu.com/p/374924046
评论