在梳理Docker的相关历史发展的时候,知道了现阶段容器化技术的实现基础其实依赖Linux内核的两大核心功能:Namespace和Cgroups,分别用来进行资源的隔离和使用限制;这两大功能是Linux为了虚拟化分别在2002年的「 2.4.19」和2007年的「2.6.24」就开始引入的功能点;本文主要参考Namepsace的manual手册进行相关梳理,欢迎批评指正;
Linux的Namespace对系统的全局资源进行了抽象,让Namespace中的进程组可以认为他们拥有隔离的全局资源;对于Namespace拥有的全局资源进行修改,只有本Namespace中的进程可见,其他Namespace的进程是无感知的;Namespace的功能是Container实现的基础;
下面就介绍一下:各种类型的Namespace,相关Namespace的APIs,以及对应关联的/proc文件;
Namespace分类
Linux中的Namespace包含以下几种类型,第二列表示Namespace在各个APIs中的标记,第三列表示该Namespace类型对于的帮助文档,最后一列表示该类型Namespace隔离的资源类型;
| Namespace | Flag | Page | Isolates |
|---|---|---|---|
| Cgroup | CLONE_NEWCGROUP | cgroup_namespaces(7) | Cgroup root directory |
| IPC | CLONE_NEWIPC | ipc_namespaces(7) | System V IPC, POSIX message queues |
| Network | CLONE_NEWNET | network_namespaces(7) | Network devices, stacks, ports, etc. |
| Mount | CLONE_NEWNS | mount_namespaces(7) | Mount points |
| PID | CLONE_NEWPID | pid_namespaces(7) | Process IDs |
| Time | CLONE_NEWTIME | time_namespaces(7) | Boot and monotonic clocks |
| User | CLONE_NEWUSER | user_namespaces(7) | User and group IDs |
| UTS | CLONE_NEWUTS | uts_namespaces(7) | Hostname and NIS domain name |
Namespace相关API
Linux提供了以下几个相关的系统调用级别的API,用来控制进程相关的Namepsace的变更;
系统调用clone用于创建一个子进程,和fork的差异是,它允许在创建子进程的时候传入特定的FLAG来控制子进程从父进程继承的相关信息;其中CLONE_NEW开头的FLAG用来创建新的各种类型的Namespace;
系统调用setns允许进程加入一个已经存在的Namespace,Linux Namepsace没有什么名字的概念,都是通过Namespace文件进行管理的,所以setns需要传入的是Namespace的文件,位于/proc/[pid]/ns下面;
系统调用unshare允许调用进程加入一个新的Namespace,和clone一样,通过传入CLONE_NEW开头FLAG来创建对应类型的Namespace;
系统调用提供ioctl接口,可以通过Namespace对应fd,来获取含有层级Namespace(PID Namespace和User Namespace)相关Namespace信息的功能,也可以支持获取Namespace 类型的功能;
下面的功能测试,都会以clone内核接口做测试,其他接口不再多做介绍;
Namespace相关结构
每一个进程的Namespace信息都存储在/proc/[pid]/ns下面;如下查看当前进程的Namespace信息:
bash# ll /proc/self/ns
total 0
lrwxrwxrwx 1 root root 0 Oct 30 19:10 cgroup -> 'cgroup:[4026531835]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 ipc -> 'ipc:[4026531839]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 mnt -> 'mnt:[4026531840]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 net -> 'net:[4026531993]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 pid -> 'pid:[4026531836]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 pid_for_children -> 'pid:[4026531836]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 user -> 'user:[4026531837]'
lrwxrwxrwx 1 root root 0 Oct 30 19:10 uts -> 'uts:[4026531838]'
进程的每一种类型Namespace都有一个对应的文件,在Linux「3.7」及以前,这些文件都是硬链接,从Linux「3.8」开始,每一个Namepsace文件都是一个符号连接;
一个进程在被创建的时候,如果不指定特殊类型的Namespace,那么将会继承父进程的所有Namepsace,即各个类型的资源都和父进程同处一个Namespace,对该Namespace的全局资源的修改,是父子进程都可见的;
我们在进程中直接打开这些Namespace文件,然后通过相关API进行Namespace的设置,只要这些Namespace文件被打开,该Namepsace就会一致存在,不管Namespace中的所有进程是否结束;
通过util-linux提供的lsns命令来列出系统中目前所有的Namespace
shell# lsns
NS TYPE NPROCS PID USER COMMAND
4026531836 pid 255 1 root /usr/lib/systemd/systemd --switched-root --system --deserialize 22
4026531838 uts 255 1 root /usr/lib/systemd/systemd --switched-root --system --deserialize 22
4026531839 ipc 253 1 root /usr/lib/systemd/systemd --switched-root --system --deserialize 22
4026531840 mnt 254 1 root /usr/lib/systemd/systemd --switched-root --system --deserialize 22
4026531857 mnt 1 87 root kdevtmpfs
4026531957 net 255 1 root /usr/lib/systemd/systemd --switched-root --system --deserialize 22
4026532269 ipc 1 31428 root ./a.out NEWIPC
Namepsace类型解析
PID Namespace
通过PID Namespace可以让Namepsace中的进程的PID资源做到全局隔离,让进程认为自己的PID资源是全局的资源,从而做到很好的隔离性;使用过Container的同学会知道,Container中作为exec模式的启动进程是PID为1的进程,但是1号进程在现在Linux发行版中都是systemd1号管理进程;了解了PID Namespace就了解了Conatiner的是如何做到PID管理的;
下面我们首先通过clone的CLONE_NEWPID flag,让创建的子进程拥有独立的PID Namespace,如下测试代码(参考clone的manual文档):
c++static int ChildEnterNewPID(void *arg) {
pid_t pid = getpid();
pid_t ppid = getppid();
printf("in child: pid=%d\n", pid);
printf("in child: parent_pid=%d\n", ppid);
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewPID, stackTop, CLONE_NEWPID | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
printf("in parent: clone() returned child pid=%ld\n", (long)pid);
sleep(1); /* Give child time to do something */
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
输出结果如下:
bashin parent: clone() returned child pid=18285
in child: pid=1
in child: parent_pid=0
可以看出,父进程返回的的子进程的pid为18285,子进程中获取到的自己的进程ID为1,父进程ID为0;我们知道,Linux中进程ID为1的是systemd进程,它是所有进程的祖先进程;这里通过PID Namespace将不同Namespace之间的PID序号进行隔离,这就是我们看到为什么Container中exec模式启动的进程的PID是1,就是使用了PID Namespace进行了隔离;
通过lsns查看当前系统中的所有Namespace信息,如下:
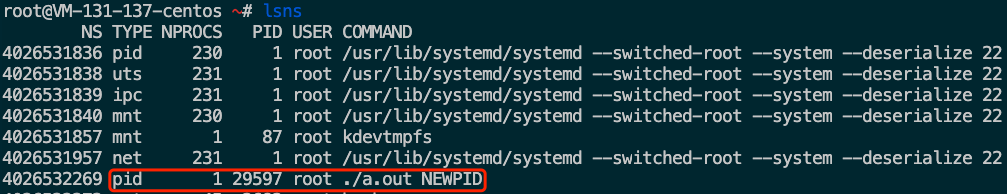
clone的子进程创建了一个新的PID Namespace「4026532269」,所以子进程在新的PID Namespace创建生成的PID=1,和父进程的Namespace是隔离的,子进程并看不到父进程中PID=1的systemd祖先进程;
我们可以看到虽然不同的PID Namespace中PID资源是隔离的,但是PID Namespace是有层级关系的;新创建的PID Namespace中的进程,不仅有该PID Namespace中的PID,在父进程的PID Namespace中,它也存在一个对应的PID;也就是一个进程在上层的PID Namepsace会拥有和本PID Namespace中不一样的隔离的PID编号;
在「Linux 2.6.24」版本中,引入了PID Namespace,可以看到Linux内核中Linux的PID和Namespace相关的结构定义如下:
c// https://github.com/torvalds/linux/blob/v6.0/include/linux/sched.h
// 内核进程的结构定义
struct task_struct {
...
/* PID/PID hash table linkage. */
struct pid *thread_pid;
...
}
// https://github.com/torvalds/linux/blob/v6.0/include/linux/pid_namespace.h
// 内核中pid namespace的结构定义
struct pid_namespace {
...
unsigned int pid_allocated; // 当前pid namepsace中已经创建的的pid个数
struct task_struct *child_reaper;
struct kmem_cache *pid_cachep;
unsigned int level; // 当前namespace的层级,继承自初始namespace,创建新namespace,level = parent->level + 1
struct pid_namespace *parent;
struct user_namespace *user_ns;
...
}
// https://github.com/torvalds/linux/blob/v6.0/include/linux/pid.h
// 保存pid值的结构,为struct pid的子结构
struct upid {
int nr; // 当前namespace的pid数值
struct pid_namespace *ns; // 关联的pid_namespace信息
};
// 内核中一个进程的标识符
struct pid
{
refcount_t count;
unsigned int level; // 该进程位于pid namespace的层级
...
struct upid numbers[1]; // pid所有的namespace层级的pid值信息
};
linux内核再每个进程创建的时候,都会生成一个struct task_struct结构,绑定对应创建的进程标识struct pid,struct pid的创建流程如下:
c// https://github.com/torvalds/linux/blob/v6.0/kernel/pid.c
struct pid *alloc_pid(struct pid_namespace *ns, pid_t *set_tid,
size_t set_tid_size)
{
struct pid *pid;
enum pid_type type;
int i, nr;
struct pid_namespace *tmp;
struct upid *upid;
int retval = -ENOMEM;
...
// 分配pid memory
pid = kmem_cache_alloc(ns->pid_cachep, GFP_KERNEL);
if (!pid)
return ERR_PTR(retval);
tmp = ns;
// 保存当前进程所属的namespace的层级
pid->level = ns->level;
for (i = ns->level; i >= 0; i--) {
int tid = 0;
...
// 按照namespace所在的层级:依次为pid在各个namespace生成一个pid号
if (tid) {
nr = idr_alloc(&tmp->idr, NULL, tid,
tid + 1, GFP_ATOMIC);
/*
* If ENOSPC is returned it means that the PID is
* alreay in use. Return EEXIST in that case.
*/
if (nr == -ENOSPC)
nr = -EEXIST;
} else {
int pid_min = 1;
/*
* init really needs pid 1, but after reaching the
* maximum wrap back to RESERVED_PIDS
*/
if (idr_get_cursor(&tmp->idr) > RESERVED_PIDS)
pid_min = RESERVED_PIDS;
/*
* Store a null pointer so find_pid_ns does not find
* a partially initialized PID (see below).
*/
nr = idr_alloc_cyclic(&tmp->idr, NULL, pid_min,
pid_max, GFP_ATOMIC);
}
...
// 将各个层级pid和namespace信息顺序存储在struct pid的number结构中
pid->numbers[i].nr = nr;
pid->numbers[i].ns = tmp;
tmp = tmp->parent;
}
...
upid = pid->numbers + ns->level;
...
for ( ; upid >= pid->numbers; --upid) {
/* Make the PID visible to find_pid_ns. */
idr_replace(&upid->ns->idr, pid, upid->nr);
upid->ns->pid_allocated++;
}
...
}
上述创建struct pid的逻辑中,关于PID Namespace最核心的就是:按照当前Namespace所在的层级,为当前的进程,依次创建各个层级对应的进程PID值;如下图就是在多层级的Namespace中,PID的组织关系:
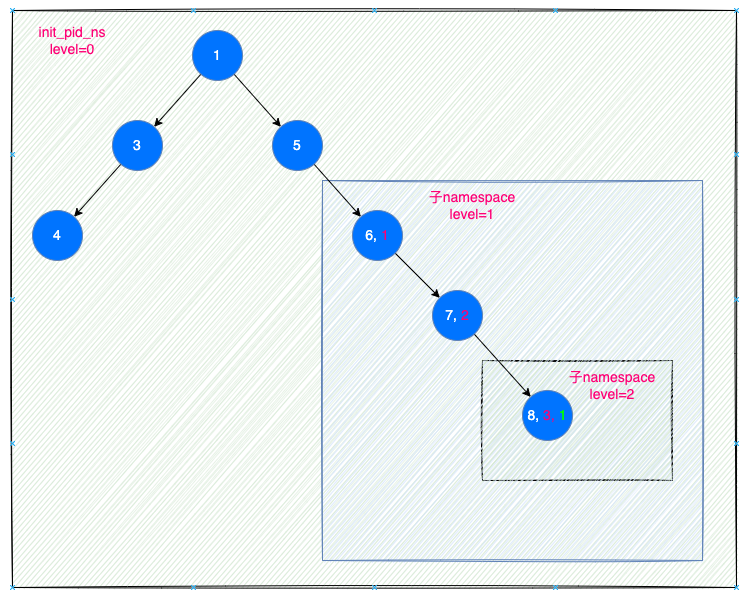
可以看一下,内核代码中,是如何通过struct pid来查询一个进程的全局PID值和具体PID Namespace中的PID值的:
c// https://github.com/torvalds/linux/blob/v6.0/include/linux/pid.h
/*
* the helpers to get the pid's id seen from different namespaces
*
* pid_nr() : global id, i.e. the id seen from the init namespace;
* pid_vnr() : virtual id, i.e. the id seen from the pid namespace of
* current.
* pid_nr_ns() : id seen from the ns specified.
*
* see also task_xid_nr() etc in include/linux/sched.h
*/
static inline pid_t pid_nr(struct pid *pid)
{
pid_t nr = 0;
if (pid)
nr = pid->numbers[0].nr; // 初始Namespace中的PID就是全局PID值,全局唯一
return nr;
}
// https://github.com/torvalds/linux/blob/v6.0/kernel/pid.c
pid_t pid_vnr(struct pid *pid)
{
return pid_nr_ns(pid, task_active_pid_ns(current));
}
pid_t pid_nr_ns(struct pid *pid, struct pid_namespace *ns)
{
struct upid *upid;
pid_t nr = 0;
// 通过PID Namespace的层级在struct pid中定位对应层级Namespace中改PID的值
if (pid && ns->level <= pid->level) {
upid = &pid->numbers[ns->level];
if (upid->ns == ns)
nr = upid->nr;
}
return nr;
}
User Namespace
Linux提供了对用户名和用户组的全局资源进行隔离的能力,User Namespace,它允许进程可以在一个Namespace中以root特权用户进行运行,但是在其他Namepsace中,只有普通的用户权限;
Linux是通过User IDs和Group IDs进行权限管理的,一个进程在Namespace的内部和外部可以拥有不同的User和Group IDs;User Namespace和PID Namespace一样,是分层级的,可以嵌套的,每一个User Namespace都继承了其父进程的User Namespace;
如下测试用例,通过CLONE_NEWUSER标记可以在创建子进程的时候,创建新的User Namespace,然后在父子进程中,输出对应的用户信息,如下;
c++static int ChildEnterNewUser(void *arg) {
printf("in child:\n");
system("id");
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewUser, stackTop, CLONE_NEWUSER | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
printf("in parent: clone() returned child pid=%ld\n", (long)pid);
sleep(1); /* Give child time to do something */
system("id");
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
用普通用户waklerdu执行测试返回结果如下:
bash~> ./a.out NEWUSER
in parent: clone() returned child pid=7165
in child:
uid=65534(nobody) gid=65534(nogroup) groups=65534(nogroup)
in parent:
uid=1001(walkerdu) gid=1001(walkerdu) groups=1001(walkerdu)
我们发现在子进程中看到的用户信息User ID是65534,和在外部看该子进程仍然属于walkerdu是不一样的;那么User Namepace是如何实现进程在不同的Namespace下,可以有不同的用户权限的?
其实是通过不同Namespace的User和Group ID映射来实现的;每一个进程下的/proc/[pid]/uid_map和 /proc/[pid]/gid_map定义了该User Namespace和父User Namespace的User和Group的映射关系;当一个User Namespace创建的时候,默认不会从Parent Namespace中进行User和Group IDS的映射,也就是新创建的User Namepsace的进程中,/proc/[pid]/uid_map和 /proc/[pid]/gid_map是空的,如下:
bash# 父进程所在User Namepsace,对应的User和Group映射数据
$cat /proc/7164/uid_map /proc/7164/gid_map
0 0 4294967295
0 0 4294967295
# 子进程通过NEWUSER创建了新的User Namepsace,对应的User和Group映射数据为空
$cat /proc/7165/uid_map /proc/7165/gid_map
$
/proc/[pid]/uid_map和 /proc/[pid]/gid_map是的格式如下:有三个数字类型的field组成,空格分割:
bashfield1 field2 field3
- field1:当前进程所在User Namespace的起始User ID;
- field2:如果父子进程在不同的User Namespace中,那么此字段就是父进程的User Namespace的开始User ID;如果父子进程处在相同的User Namespace中,那么该字段就是该User Namepsace的起始User ID
- field3:表示映射的User ID的长度;
其实参考阐述Namespaces in operation,/proc/[pid]/uid_map和 /proc/[pid]/gid_map是的格式解释为一下更好理解:
bashID-inside-ns ID-outside-ns length
第一个字段为新User Namespace下起始的User ID, 第二个字段是父User Namespace下的起始User ID;
如果新创建的User Namespace中没有配置(默认无)User和Group IDS 映射,那么获取User ID信息会默认读取/proc/sys/kernel/overflowuid的配置,即65534,这就是上面的测试代码在新的User Namespace中为什么会输出
bashin child:
uid=65534(nobody) gid=65534(nogroup) groups=65534(nogroup)
那么如何对新创建的User Namespace配置User和Group IDS映射呢;在进行User Namespace的User和Group IDs映射前,有以下几个关于修改映射规则的限制;
- 每个User Namespace的User和Group IDs的映射只能进行修改一次;且最多只可以添加5行,最少需要写入1行;
/proc/[pid]/uid_map和/proc/[pid]/gid_map只属于该User Namespace的创建用户,也只能由该用户或者特权用户进行修改;
所以我们可以像Container一样,指定运行的用户User ID和Group ID;
如下,修改上述测试 代码,在父进程中,将新User Namespace中的root用户映射为外部User Namespace的walkerdu用户:
c++static int ChildEnterNewUser(void *arg) {
printf("in child:\n");
system("id");
// 等待父进程设置uid_map
sleep(2);
printf("in child: after parent set uid_map\n");
system("id");
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewUser, stackTop, CLONE_NEWUSER | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
printf("in parent: clone() returned child pid=%ld\n", (long)pid);
sleep(1); /* Give child time to do something */
system("id");
// 设置子进程的User ID映射,
std::string cmd = "echo '0 1001 1' > /proc/" + std::to_string(pid) + "/uid_map";
system(cmd.c_str());
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
如下测试结果:
bash$ ./a.out NEWUSER
in parent: clone() returned child pid=10187
in child:
uid=65534(nobody) gid=65534(nogroup) groups=65534(nogroup)
in parent:
uid=1001(walkerdu) gid=1001(walkerdu) groups=1001(walkerdu)
in child: after parent set uid_map
uid=0(root) gid=65534(nogroup) groups=65534(nogroup)
User Namespace是比较特殊的Namespace,所有其他类型的Namepsace(NonUser Namespace)在创建的时候都会绑定它所在的User Namespace,对于在这些NonUser Namespace中需要特权权限对资源进行操作,需要其对应绑定的User Namespace拥有对应的特权权限;
在Linux「3.8」以前,所有类型的Namespace的创建都需要特权用户权限,从Linux「3.8」开始,创建User Namespace不需要特权用户权限;
如果CLONE_NEWUSER和其他CLONE_NEW*一起设置,那么系统会保证新的User Namespace优先创建,然后对应进程会被临时赋予特权创建其他类型的Namespace,并绑定新创建的User Namespace上;
如下所示,可以看到PID Namepsace中也绑定了对应所属的User Namespace:
c// https://github.com/torvalds/linux/blob/v6.0/include/linux/pid_namespace.h
// 内核中pid namespace的结构定义
struct pid_namespace {
...
unsigned int pid_allocated; // 当前pid namepsace中已经创建的的pid个数
struct task_struct *child_reaper;
struct kmem_cache *pid_cachep;
unsigned int level; // 当前namespace的层级,继承自初始namespace,创建新namespace,level = parent->level + 1
struct pid_namespace *parent;
struct user_namespace *user_ns; // 绑定对应的User Namespace
...
}
如下是User Namespace的定义:
c// https://github.com/torvalds/linux/blob/v6.0/include/linux/user_namespace.h
// 内核中user namespace的结构定义
struct user_namespace {
struct uid_gid_map uid_map;
struct uid_gid_map gid_map;
struct uid_gid_map projid_map;
struct user_namespace *parent; // 父User Namespace
int level; // 当前User Namespace所在的初始User Namespace的层级关系,和PID Namespace的管理方式一致的
kuid_t owner;
kgid_t group;
struct ns_common ns;
unsigned long flags;
/* parent_could_setfcap: true if the creator if this ns had CAP_SETFCAP
* in its effective capability set at the child ns creation time. */
bool parent_could_setfcap;
...
struct ucounts *ucounts;
long ucount_max[UCOUNT_COUNTS];
} __randomize_layout;
IPC Namespace
IPC Namespace是Namespace提供的全局资源的隔离的一种,它提供了System V IPC和POSIX message queues的全局资源按Namespace隔离的功能,我们知道:
- System V IPC包含:message queue,semaphore ,shared memory;全部支持按Namespace进行资源隔离;
- POSIX IPC只支持message queue的Namespace的隔离;
如下测试:
c++static int ChildEnterNewIPC(void *arg) {
key_t key = 0x111111;
size_t size = 128 * 1024;
int shmid = shmget(key, size, IPC_CREAT | IPC_EXCL | 0654);
printf("in child: shmid=%d, key=0x%x\n", shmid, key);
key = 0x2222222;
shmid = shmget(key, size, IPC_CREAT | IPC_EXCL | 0654);
printf("in child: shmid=%d, key=0x%x\n", shmid, key);
printf("in child: ipcs -m info:\n");
system("ipcs -m");
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewIPC, stackTop, CLONE_NEWIPC | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
sleep(1); /* Give child time to do something */
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
执行上述测试代码,输出如下:
shell# ./a.out NEWIPC
in parent: clone() returned child pid=10892
in child: shmid=0, key=0x111111
in child: shmid=32769, key=0x2222222
in child: ipcs -m info:
------ Shared Memory Segments --------
key shmid owner perms bytes nattch status
0x00111111 0 root 654 131072 1
0x02222222 32769 root 654 131072 0
而在当前父进程所在的Namespace下面,并不能看到子进程所创建的Shared Memory的信息;所以我们在Container中使用System V IPC和POSIX message queues都会是在隔离的Namespace中,和正常OS的Namespace中的所有IPC是相互隔离,不可见的;
目前看IPC Namespace下默认第一个创建的Shared Memory IPC的shmid为0;
Mount Namespace
我们知道Unix-like的操作系统中,文件系统是一个以/为根的一个Big Tree树状结构;文件系统的files可以被各种设备挂载;mount命令就是用来将各种设备挂载到文件系统的Big Tree上;Linux中所有的挂载信息是维护在一个vfsmount数据结构中,如下:
cstruct vfsmount {
struct dentry *mnt_root; /* root of the mounted tree */
struct super_block *mnt_sb; /* pointer to superblock */
int mnt_flags;
struct user_namespace *mnt_userns;
} __randomize_layout;
Linux Namespace提供了clone该挂载数据的功能,可以在独立的Mount Namespace中进行文件系统的挂载,而不影响到其他的Namespace,Mount Namespace是Linux引入的第一个Namespace类型,发布于2002年的Linux「2.4.19」;
在引入Mount Namespace后,需要知道共享子树(Shared subtrees)的概念,共享子树是为了解决,在挂载一个新的资源的时候,需要在在不同的Namepsace下手动执行挂载操作, Linux 「2.6.15」引入了shared subtrees feature ,可以支持在一个Namespace下进行资源挂载后,能够自动,可控的在不同的Namespace间进行传递;
如下关于Mount Namespace隔离的测试,将当前目录挂载到/rootfs/data目录:
c++static int ChildEnterNewMount(void *arg) {
printf("in child:\n");
system("mkdir -p /rootfs/data");
system("mount --bind . /rootfs/data");
system("mount");
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewMount, stackTop, CLONE_NEWNS | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
sleep(1); /* Give child time to do something */
system("mount");
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
上述代码的测试结果,会发现父子进程虽然已经创建了不同的Mount Namespace,但是挂载的结果在两个Namespace都是可见的;原因参考Shared subtree对等组默认传递方式:
According to these rules, the root mount would be
MS_PRIVATE, and all descendant mounts would by default also beMS_PRIVATE. However,MS_SHAREDwould arguably have been a better default, since it is the more commonly employed propagation type. For that reason,systemdsets the propagation type of all mount points toMS_SHARED. Thus, on most modern Linux distributions, the default propagation type is effectivelyMS_SHARED.
所以在测试上述代码之前,需要执行如下指令,将根挂载点的传递类型修改为MS_PRIVATE方式,以阻止根目录的挂载传递到其他Namespace;
textmount --make-private /
执行测试结果如下:子进程创建的挂载点,在父进程中并不能看到;
bash# ./a.out NEWNS
in parent: clone() returned child pid=18875
in child:
/dev/vda1 on / type ext4 (rw,relatime,errors=remount-ro,data=ordered)
...
/dev/vda1 on /rootfs/data type ext4 (rw,relatime,errors=remount-ro,data=ordered)
in parent:
...
/dev/vda1 on / type ext4 (rw,relatime,errors=remount-ro,data=ordered)
...
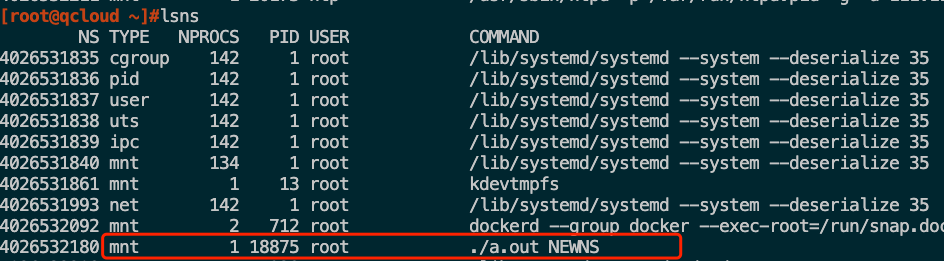
同时通过lsns可以查看到,子进程创建了新的Mount Namespace和父进程的Namespace隔离开了;
Network Namespace
Linux支持针对全局资源Network Device按Namespace进行隔离,这样Container可以很方便的使用自己虚拟出的网卡资源,和其他Namespace项目隔离,互不影响;
下面是测试代码,通过CLONE_NEWNET flag clone出的子进程独立的NetWork资源,通过ip address命令查看系统中的网络设备以及其地址信息;
c++static int ChildEnterNewNet(void *arg) {
printf("in child:\n");
system("ip address");
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewNet, stackTop, CLONE_NEWNET | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
printf("in parent: clone() returned child pid=%ld\n", (long)pid);
sleep(1); /* Give child time to do something */
printf("in parent:\n");
system("ip address");
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
执行结果如下:父进程输出的Network信息如下:
bashin parent: clone() returned child pid=22338
in parent:
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN
link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
inet 127.0.0.1/8 scope host lo
valid_lft forever preferred_lft forever
2: eth1: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc mq state UP qlen 1000
link/ether 52:54:00:7f:45:73 brd ff:ff:ff:ff:ff:ff
inet 9.134.131.137/21 brd 9.134.135.255 scope global eth1
valid_lft forever preferred_lft forever
3: docker0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP
link/ether 02:42:dd:ed:84:53 brd ff:ff:ff:ff:ff:ff
inet 192.168.10.1/24 brd 192.168.10.255 scope global docker0
valid_lft forever preferred_lft forever
7: veth9e2fdfe: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue master docker0 state UP
link/ether 8a:c4:d5:22:a3:32 brd ff:ff:ff:ff:ff:ff
子进程中输出的Network信息如下:
bashin child:
1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN
link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
可以看出子进程看到的Network资源信息和父进程是不同的,我们通过lsns查看当前系统中Namespace信息如下:
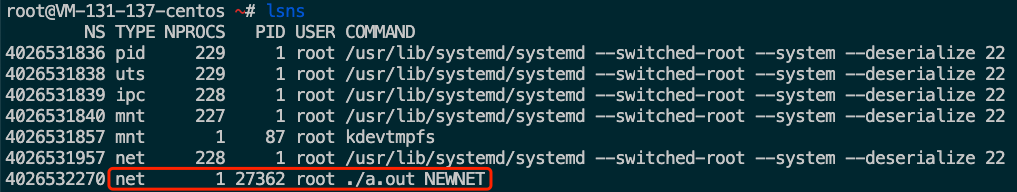
clone的子进程创建了一个新的Network Namespace「4026532270」,所以它所看到的Network都是新的Namespace中的,而不是父进程所在的Namespace中的;
Cgroup Namespace
Cgroups是容器化技术的另一个核心实现基础,Cgroups是Linux「2.6.24」内核版本引入的特性,用于对一组进程使用的资源(CPU,内存等)进行严格的限制,记录和隔离;针对Cgroups也可以通过Namespace来进行隔离,Cgroup Namespace是Linux 「4.6」以后才引入的特性,让不同Namespace中的进程组中使用的不同cgroups进行资源限制;
如下测试代码,通过clone的CLONE_NEWCGROUP flag来是子进程使用的cgroups和父进程的cgroups隔离开:
c++static int ChildEnterNewCgroup(void *arg) {
printf("in child:\n");
pid_t pid = getpid();
std::string cmd = "cat /proc/" + std::to_string(pid) + "/cgroup";
system(cmd.c_str());
sleep(200);
return 0;
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewCgroup, stackTop, CLONE_NEWCGROUP | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
printf("in parent: clone() returned child pid=%ld\n", (long)pid);
sleep(1); /* Give child time to do something */
printf("in parent:\n");
pid_t pid = getpid();
std::string cmd = "cat /proc/" + std::to_string(pid) + "/cgroup";
system(cmd.c_str());
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
执行结果如下,子进程输出的cgroup信息:
bashin child:
12:perf_event:/
11:freezer:/
10:pids:/
9:devices:/
8:hugetlb:/
7:net_cls,net_prio:/
6:cpu,cpuacct:/
5:rdma:/
4:memory:/
3:blkio:/
2:cpuset:/
1:name=systemd:/
0::/
父进程输出的cgroup信息:
bashin parent:
12:perf_event:/
11:freezer:/
10:pids:/user.slice/user-1001.slice/session-124608.scope
9:devices:/user.slice
8:hugetlb:/
7:net_cls,net_prio:/
6:cpu,cpuacct:/user.slice
5:rdma:/
4:memory:/user.slice
3:blkio:/user.slice
2:cpuset:/
1:name=systemd:/user.slice/user-1001.slice/session-124608.scope
0::/user.slice/user-1001.slice/session-124608.scope
UTS Namespace
Linux Namespace支持主机名字的隔离:UTS Namespace,在同一个UTS Namespace中的进程看到的HostName可以和其他UTS Namespace的进程不一致,这个比较简单明了,直接测试如下:
c++static int ChildEnterNewUTS(void *arg) {
struct utsname uts;
/* Change hostname in UTS namespace of child */
if (sethostname((const char *)arg, strlen((const char *)arg)) == -1) errExit("sethostname");
/* Retrieve and display hostname */
if (uname(&uts) == -1) errExit("uname");
printf("uts.nodename in child: %s\n", uts.nodename);
sleep(200);
return 0; /* Child terminates now */
}
int main(int argc, char *argv[]) {
...
pid = clone(ChildEnterNewUTS, stackTop, CLONE_NEWUTS | SIGCHLD, argv[2]);
if (pid == -1) errExit("clone");
printf("in parent: clone() returned child pid=%ld\n", (long)pid);
sleep(1); /* Give child time to do something */
struct utsname uts;
if (uname(&uts) == -1) errExit("uname");
printf("uts.nodename in parent: %s\n", uts.nodename);
...
if (waitpid(pid, NULL, 0) == -1) /* Wait for child */
errExit("waitpid");
...
}
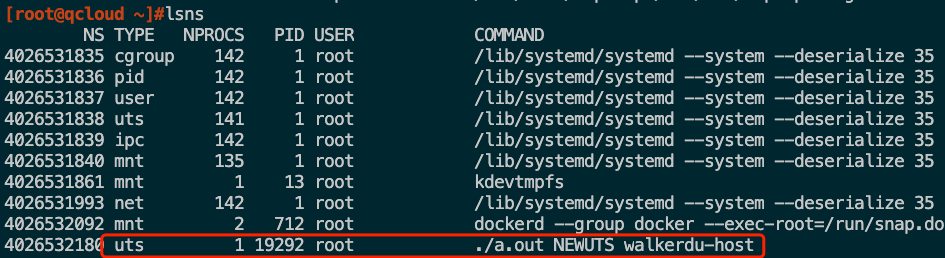
测试结果如下:
bash# ./a.out NEWUTS walkerdu-host
in parent: clone() returned child pid=19292
uts.nodename in child: walkerdu-host
uts.nodename in parent: qcloud
Namespace的生命周期
各个类型的Namespace在没有干扰因素的情况下,当Namespace中的最后一个进程终止或者离开该Namespace的时候,此Namespace会自动销毁。但是有很多其他的因素,会导致该Namespace没有任何进程的时候,该Namespace仍然会存在:如下
- 对应的
/proc/[pid]/ns/*被打开,或者挂载; - 包含层级关系的Namespace(PID & User Namepsace),含有子Namespace;所有的Namespace中有两个比较特殊的Namespace,PID和User Namespace,这两个Namespace在设计中,是分级的;
- 一个User Namespace绑定了未销毁的NonUser Namespace;
- 一个进程通过
/proc/[pid]/ns/pid_for_children引用PID Namespace; - 一个进程通过
/proc/[pid]/ns/time_for_children引用Time Namespace; - IPC Namespace对应的mqueue 文件系统被挂载;
- PID Namespace对应的proc文件系统被挂载;
参考
https://coolshell.cn/articles/17010.html
https://coolshell.cn/articles/17029.html
https://www.cnblogs.com/zhrx/p/16388175.html
https://man7.org/linux/man-pages/man7/namespaces.7.html
Separation Anxiety: A Tutorial for Isolating Your System with Linux Namespaces
评论