ZooKeeper:分布式应用的分布式协调程序(官方介绍定义)。曾经是Hadoop的一个子项目,但现在是Apache的一个独立的顶级项目。它提供了一组简单的原语,应用程序可以在此之上实现更高级别的服务:分布式同步、配置管理、集群管理、命名服务等。
ZooKeeper的设计易于编程,并且使用了类似文件系统目录树结构的数据模型。zk是java编写的,需要在java虚拟机中运行,并且提供了java和C的client api。
众所周知,协调服务很难做到, 特别容易出现诸如竞争条件和死锁等错误。 ZooKeeper设计的目的是为了避免分布式应用程序从头开始做协调服务的工作。ZooKeeper底层采用Paxos一致性协议进行同步,类似的,etcd采用Raft一致性协议,这里放到后面的文章来说,下面是通过ZooKeeper官方文档来进行简单的ZK介绍。
1. Design Goals
ZooKeeper允许分布式进程通过共享的层级命名空间相互协调,该命名空间的组织方式与标准文件系统类似。命名空间由称作Znode的数据节点组成,与文件系统的文件和目录概念类似,但与专为存储而设计的典型文件系统不同,ZooKeeper数据保存在内存中,原因很简单,为了实现高吞吐量和低延迟。
ZooKeeper的实现以高性能,高可用性,严格有序访问为设计目标。ZooKeeper的高性能意味着它可以在大型分布式系统中使用,可靠性使其不会成为单点故障,严格的有序访问意味着可以在客户端实现复杂的同步原语。
下图是ZooKeeper服务的组成示意图(引用:官网)
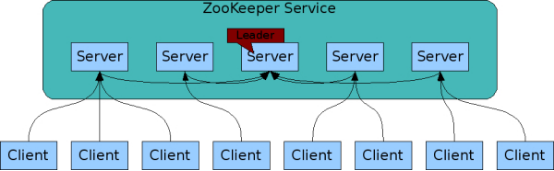
组成ZooKeeper服务的server必须感知到彼此,它们在内存中的维护各个server的状态,以及对事务日志和快照进行持久化。ZooKeeper保证只要大多数服务器可用((N+1)/(2N+1)),整个服务就是可用的。
client通过TCP连接到单个server,通过该连接发送请求,获取响应,获取监视事件以及发送心跳,当该TCP连接断开后,client会自动连接到其他server(如何实现?)。
ZooKeeper有以下两个很重要的特性:
- 有序(ZooKeeper is ordered): ZooKeeper对每个更新会标记一个数字,以反映zk事务的顺序,后续操作可以使用该顺序来实现更高级别的抽象,例如同步原语。
- 快速(ZooKeeper is fast):在读频繁的场景下,ZooKeeper的性能更快,在数千台计算机上运行,并且在读写比为10:1的情况下,性能表现最佳。
2. Data model and the hierarchical namespace
前面提到过,ZooKeeper的层级名字空间与标准文件系统类似。名字由斜杠(/)分隔的元素路径,ZooKeeper名称空间中的每个节点都由路径标识的。如下图,来自官网
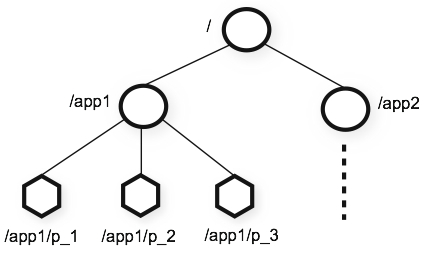
与标准文件系统不同,ZooKeeper名字空间中的每个节点都可以包含与之关联的数据以及其子节点的数据。类似于一个允许文件也是目录的文件系统。 (ZooKeeper旨在存储协调数据以及相关状态信息,配置,位置信息等,因此存储在每个节点的数据通常很小,大小在B~KB之间)。
2.1 ZNode
ZK的每个节点称之为ZNode,ZNode的名字由斜杠(/)分隔,只能用绝对路径表示。ZNode的名字可以用任意Unicode字符组成,除了以下几种:
- 空字符(\u0000)
- 不可见字符:\u0001 - \u0019 and \u007F - \u009F
- '.'和'..'不可以单独出现在路径中,因为ZNode的名字只能是绝对路径,例如,/a/b/./c是非法的,但/a/b/.c是有效的
- zookeeper是保留名字,不建议使用。(但实测可以使用)
ZNode由两部分组成:协调数据和状态数据,
-
协调数据:业务相关的数据
-
状态结构数据包含:数据变更的版本号, ACL(Access Control List)变更,时间戳,以用来缓存验证和协调更新。每次Znode数据发生变化,版本号就会自增。
下面是通过client连上ZooKeeper获取的一个ZNode详细信息:
shell[zk: localhost:2181(CONNECTED) 7] create /znode_test 'znode data'
Created /znode_test
[zk: localhost:2181(CONNECTED) 8] get /znode_test
znode data
# 以下都是ZNode状态结构数据
cZxid = 0x7 #znode被创建时的zxid
ctime = Fri Oct 05 09:18:49 CST 2018
mZxid = 0xc
mtime = Fri Oct 05 09:26:09 CST 2018
pZxid = 0x7
cversion = 0
dataVersion = 3
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 5
numChildren = 0
ZNode的状态结构中的各个field如下:
- czxid: znode被创建时的zxid(ZooKeeper Transaction Id),对ZooKeeper的每次更改都会以zxid进行标记
- mzxid: znode最近一次被修改的zxid
- pzxid: znode的子节点最近一次被修改的zxid
- ctime: znode被创建时的毫秒数(格林威治时间)
- mtime: znode最近一次被修改的毫秒数
- dataVersion: znode数据的变更次数
- cversion: znode子节点变更次数
- aversion: znode ACL变更次数
- ephemeralOwner: 当znode是临时node的时候,表示znode所有者的会话ID, 否则该字段是0
- dataLength: znode 数据字段的长度
- numChildren: znode子节点的个数
2.2 ZNode节点类型
Znode按生命周期的不同可以分为:
- Persistent Nodes:持久化的Znode:创建之后,一直存在,除非主动进行删除。ZNode默认为该类型。
- Ephemeral Nodes:临时的Znode,随着会话的创建而产生,在会话的生命周期内存在,会话结束Znode会被自动销毁
此外,ZNode具有Sequence Nodes 即顺序编号的节点类型。当创建一个Sequence ZNode的时候,会在节点路径后增加一个单调递增的计数器,生成的节点名的结构如:
以下是一个Sequence Node的使用示例,在初始正常目录结构/walker/a下的测试:
python>>> zk.create('/walker/b', value='node data', acl=None, ephemeral=False, sequence=True)
u'/walker/b0000000001'
>>> zk.create('/walker/b', value='node data', acl=None, ephemeral=False, sequence=True)
u'/walker/b0000000002'
>>> zk.create('/walker/a', value='node data', acl=None, ephemeral=False, sequence=True)
u'/walker/a0000000003'
>>> zk.create('/walker/a/du', value='node data', acl=None, ephemeral=False, sequence=True)
u'/walker/a/du0000000000'
大家可以思考以下,为什么/walker节点下第一个创建的顺序编号节点b的名字/walker/b0000000001是0000000001结尾的,而/walker/a节点下第一个创建的顺序编号节点du的名字/walker/a/du0000000000是0000000000结尾的?
上面的几种ZNode类型可以结合使用,所以会存在以下四种类型的ZNode:
- Persistent Node(默认ZNode类型)
- Persistent Sequence Node
- Ephemeral Node
- Ephemeral Sequence Node
3. Time in ZooKeeper
ZooKeeper有多种方式来追踪时序,其中也是ZK比较重要的名词:
- Zxid(ZooKeeper Transaction Id): 对ZooKeeper的每次更改都会以zxid进行标记,每个变更都有一个唯一的zxid,如果zxid1 < zxid2, 那么zxid1比zxid2早发生。
- Version numbers: 对ZooKeeper的每次更改都会增加Znode中的一个版本号,有三种版本号:version(znode 数据的变更次数), cversion(znode的子节点变更次数), aversion(znode的ACL的变更次数)。
- Ticks: ZooKeeper集群中,server通过Ticks来判断相关事件,例如:状态上报,会话超时,连接超时。
- Real Time: ZooKeeper中不会使用日历时间,除了在Znode的创建和修改的时候更新相关的时间戳
4. Guarantees
前面也提到了ZooKeeper以高性能,高可用性,严格有序访问为设计目标。ZooKeeper有以下保证:
- 顺序一致性(Sequential Consistency): 客户端的更新会按照发送顺序进行操作。
- 原子性(Atomicity): 更新操作只会是成功或失败,不存在其他异常结果。
- 单一视图(Single System Image): 客户端无论连接到哪个server,看到的都是相同的视图。
- 可靠性(Reliability): 当更新操作被执行后,它将一直有效,直到下一次更新操作的执行。
- 及时性(Timeliness): client的视图保证在一定时间内能得到更新。
5. Simple API
ZooKeeper的设计目标中很重要的一点就是提供一套非常简单的API, 所以ZooKeeper只支持一下几种操作:
- create: 在层级的树状Znode名字空间中创建一个节点
- delete: 删除一个Znode
- exists: 测试一个Znode是否存在
- get data: 读取Znode的数据
- set data: 写Znode的数据
- get children: 检索Znode的所有子节点
- sync: waits for data to be propagated
6. ZooKeeper Sessions
ZK Client通过ZooKeeper提供的client binding 代码(官方提供:C/Java两种Client API)创建一个handle来和ZooKeeper服务建立Session连接。创建一个handle进行连接后,client会处于CONNECTING状态,然后client library会进行尝试对ZK服务集群中的server发起连接,成功后client会置为CONNECTED状态。当发生不可恢复的错误,例如会话过期,鉴权失败,或者client主动进行关闭,handle会切换为CLOSED状态。以下是ZK client session的状态转换图:
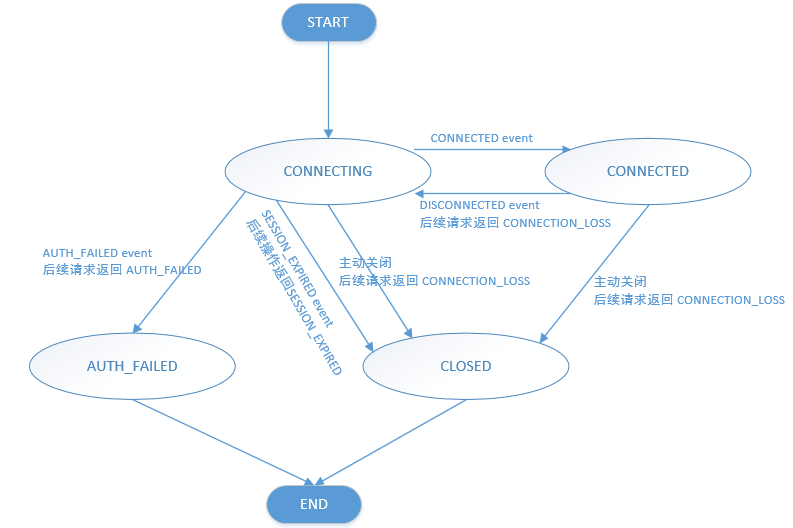
当client session state从CONNECTED由于disconnected事件变成CONNECTING后,不建议创建新的session对象进行连接,因为ZK client library会自动进行重连,特别ZK client lib中内置了一些启发式方法来处理“羊群效应”之类的事情。在使用过程中,仅需要在收到会话到期通知时进行新会话的创建???。
6.1 session的创建
下面是C client API进行会话创建的的接口,
cZOOAPI zhandle_t *zookeeper_init(const char *host, watcher_fn fn, int recv_timeout, const clientid_t *clientid, void *context, int flags);
-
host参数
ZK server地址列表,格式"ip:port",多个地址对间用逗号分隔。
-
fn参数
默认watcher,在session创建的时候需要传入一个watcher,该watcher在client的状态发生任何变化时都会收到通知,例如在client丢失集群的连接后,client会话过期等等。对于新创建的session,该watcher第一个收到的通知通常都是CONNECTED event。
-
recv_timeout参数
ZK session创建的时候,可以通过参数来控制session的超时时间:client发送请求超时,server的响应超时,该超时时间范围[2*tickTime, 20*tickTime],tickTime是server的配置时间。同样,ZK client API支持对超时时间进行协商。
-
clientid参数
之前建立连接的会话的id,用于新的client进行重连复用之前的会话
-
context参数
回调参数,和zkhandle_t的实例绑定,可以通过zoo_get_context获取到,watcher_fn回调的时候会透传回来,该参数只是client自己使用,zookeeper内部不关心,client只负责透传
-
flag参数
保留参数,将来使用。
会话的超时管理是由ZK集群负责的,不是由client负责。当ZK client 创建一个session时传入了一个合法的timeout,ZK集群就会根据该值对client的session进行过期管理。当集群在设定的timeout时间段内没有收到client的请求(心跳),集群就会认定该session过期了,集群就会将session拥有的ephemeral nodes全部删除,并通知到所有监听被删除nodes的clients(CONNECTED),如果此时该过期session的client仍然是未连接状态,将不会通知到该client,且该client将一直处于disconnected状态直到该TCP连接重连成功,重连成功后其将会收到SESSION_EXPIRED的通知。
session的保活是通过client来发送请求来实现,当在一段时间内session处于空闲状态,client会发送PING请求来使session保活,PING请求不仅可以让ZK集群直到client是活的,也能让client知道到ZK集群的连接是否是活的。
7. ZooKeeper Watches
客户端可以在znodes上设置监听,ZooKeeper中所有的read操作:getData(),getChildren()和exists(),都提供了参数来设置watch。关于watch的定义:watch事件是一个一次性的触发器,当watch的Znode发生变更的时候,ZooKeeper会向客户端发送通知。关于watch有三个重要的特性:
-
一次性触发 当监听的Znode发生变化时,会向client发生一个watch event。例如:client调用getData("/znode1", true),之后/znode1发生了变化或者删除,client会收到一个watch event,但当/znode1再次发生变化时,client不会在收到watch event,除非client再次调用read操作来设置监听。
-
watch event发送的顺序性 发送给client的watch event,在更改操作成功的返回代码到达发起更改的客户端之前,可能无法到达client。监听事件是异步发送给watcher。但ZK提供了顺序性保证:client不会发现其监听的znode发生变化直到它收到watch event。即client会先收到watch event,然后才会看到Znode的数据。Watch events的顺序和ZK集群中的对于更新的顺序是严格一致的。
-
监听的分类 ZooKeeper中存在两种watches:data watches和child watches。
getData() and exists() 接口会设置data watches。getChildren() 接口会设置child watches。之所以这么设计是因为,getData() and exists() 接口是用来返回Znode的data,而getChildren() 是返回Znode所有的children列表。setData() 会触发data watch,create() 会触发data watch和父节点的child watch,delete()也同样会触发data watch和父节点的child watch
watch的生效会触发一些事件,下面是getData(),getChildren()和exists()增加watch的接口和可能会触发的事件列表的对应关系:
- Created event:exists
- Deleted event: exists, getData, and getChildren
- Changed event:exists, getData
- Child event:getChildren
关于Watches需要注意的除了上来列出了的三个特性,还有就是由于watch的一次性触发特性,在获取watch event和发送新的请求来再次进行znode的监听之间是有延迟的,所以这中间ZNode可能发生了多次变化,但client不会有watch event的通知,这是需要注意的。
8. Implementation
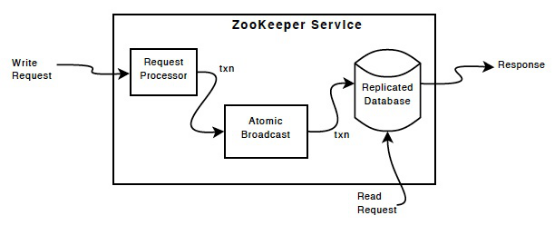
ZooKeeper集群中的各个server都要进行数据复制。
Replicated Database复制数据库是全内存的数据库,包含全部的树状Znode数据,所有更新会被写入磁盘以便进行数据恢复,写操作首先会序列化到磁盘,然后才会在内存数据库中生效。
ZooKeeper集群中每个server都可以提供client的请求,client连接到一个具体的server后可以进行发送请求,Read请求,server可以通过本地的复制数据库直接提供服务。Write请求会通过一致性协议进行更新处理。
一致性协议要求所有客户端的写请求都会被定向到单个server(称为leader),ZooKeeper集群中其他机器称为follower,followers从leader接收消息提议(Proposal)并达成消息传递, 消息层在失败后会替换leader,并同步与之连接的所有followers
9. 参考
https://github.com/liwanghong/ZooKeeper-/blob/master/架构.md
https://zookeeper.apache.org/doc/r3.4.13/zookeeperProgrammers.html
https://zookeeper.apache.org/doc/r3.4.13/zookeeperInternals.html
https://kazoo.readthedocs.io/en/latest/index.html
https://blog.csdn.net/xubo_zhang/article/details/8506163
pythonfrom kazoo.client import KazooClient
zk = KazooClient(hosts='127.0.0.1:2181')
zk.start()
zk.get_children('/')
zk.create('/kazoo_node', value='node data', acl=None, ephemeral=False, sequence=True)
zk.set('/kazoo_node', value='new node data')
评论